Zastosowanie algorytmów sztucznej inteligencji w cyberbezpieczeństwie i zabezpieczeniach wybranej aplikacji webowej, bazując na systemie IDPS
Wyższa Szkoła Ekonomii i Informatyki w Krakowie (Obecnie uniwersytet IDEIS)
- Autor: Sebastian Małek
- Praca magisterska napisana pod kierunkiem: prof. WSEI Jana Werewki
- Miejsce i rok: Kraków, 2025
Streszczenie
Niniejsza praca magisterska koncentruje się na projektowaniu i implementacji systemu Intrusion Detection and Prevention System pod tytułem „AI Web Gateway", który operuje na warstwie aplikacyjnej jako proxy HTTP/HTTPS. Z wykorzystaniem mitmproxy do przechwytywania ruchu, zastosowano modele uczenia maszynowego do analizy i detekcji zagrożeń takich jak SQL Injection, Cross-Site Scripting czy Command Injection. System został przygotowany w postaci skonteneryzowanej aplikacji możliwej do wdrożenia w chmurze, z możliwością integracji z narzędziami do analizy i prostej wizualizacji logów.
Przeprowadzone badania potwierdziły, że sztuczna inteligencja znacząco zwiększa skuteczność wykrywania zagrożeń w cyberprzestrzeni, choć równocześnie sama staje się obszarem potencjalnych ataków. Praca łączy perspektywę teoretyczną z praktyczną implementacją, wskazując, że rozwój AI w cyberbezpieczeństwie może stanowić fundament przyszłych systemów obronnych chroniących aplikacje webowe przed coraz bardziej zaawansowanymi atakami.
Słowa kluczowe: IDPS, Uczenie Maszynowe, Cyberbezpieczeństwo
Abstract
This master's thesis focuses on the design and implementation of an Intrusion Detection and Prevention System titled "AI Web Gateway", which operates at the application layer as an HTTP/HTTPS proxy. Leveraging mitmproxy for traffic interception, the system employs machine learning models to analyze and detect threats such as SQL Injection, Cross-Site Scripting (XSS), and Command Injection. The solution was developed as a containerized application, enabling deployment in cloud environments, with the option of integration with tools for log analysis and basic visualization.
The conducted research confirmed that artificial intelligence significantly enhances the effectiveness of threat detection in cyberspace, while simultaneously becoming a potential target of attacks itself. The thesis combines theoretical perspectives with practical implementation, demonstrating that the development of AI in cybersecurity can provide a foundation for future defense systems protecting web applications against increasingly sophisticated attacks.
Keywords: IDPS, Machine Learning, Cybersecurity
Spis treści
- Wstęp
- 1. Cele i założenia pracy
- 2. Analiza Wymagań Aplikacji
- 3. Implementacja Aplikacji IDPS „AI Web Gateway"
- 4. Podsumowanie
- 5. Bibliografia
- 6. Spis tabel
- 7. Spis ilustracji
- 8. Spis fragmentów kodu
Wstęp
Celem niniejszej pracy magisterskiej jest przygotowanie projektu i implementacja systemu Intrusion Detection and Prevention System pod tytułem „AI Web Gateway", działającego jako proxy HTTP/HTTPS na warstwie aplikacyjnej. Rozwiązanie to ma umożliwiać przechwytywanie ruchu sieciowego oraz jego analizę pod kątem wykrywania ataków, takich jak SQL Injection, Cross-Site Scripting czy Command Injection. W systemie wykorzystano elementy sztucznej inteligencji, które pozwalają na bardziej skuteczne i adaptacyjne wykrywanie zagrożeń w porównaniu do klasycznych systemów opartych na sygnaturach. Aplikacja została przygotowana w architekturze kontenerowej, co pozwala na jej łatwe wdrożenie w środowiskach chmurowych.
Systemy Intrusion Detection and Prevention Systems stanowią fundament ochrony infrastruktury sieciowej i aplikacyjnej. Tradycyjnie opierają się one na regułach i sygnaturach, co umożliwia szybkie wykrywanie znanych zagrożeń, lecz okazuje się niewystarczające w przypadku ataków typu zero-day czy też wariantów istniejących exploitów. Szczególnie istotne wyzwanie stanowią ataki aplikacyjne w warstwie 7 modelu ISO/OSI, takie jak SQL Injection czy Command Injection, które wykorzystują logikę działania aplikacji webowych. Ich skuteczność wynika nie tylko z wysokiego poziomu ukierunkowania na konkretną ofiarę, ale także z faktu, że klasyczne mechanizmy zabezpieczające — zapory sieciowe czy systemy IDS na poziomie transportowym — nie są w stanie w pełni analizować kontekstu semantycznego ruchu HTTP/HTTPS.
Dynamiczny rozwój cyberprzestrzeni wiąże się z rosnącą liczbą i złożonością ataków wymierzonych w aplikacje webowe. Tradycyjne systemy IDS/IPS często nie radzą sobie z nowymi wektorami ataku, zwłaszcza tymi, które operują na logice aplikacyjnej i wykorzystują protokoły HTTP/HTTPS. Z tego względu potrzebne są nowe narzędzia, które będą nie tylko reagować na znane zagrożenia, ale także uczyć się rozpoznawać wcześniej niewidziane wzorce. Autor pracy dostrzegł potencjał w połączeniu narzędzi proxy z technikami sztucznej inteligencji, co pozwala na stworzenie rozwiązania bardziej elastycznego i dopasowanego do współczesnych realiów cyberbezpieczeństwa.
Autor pracy postawił sobie za cel opracowanie i wdrożenie aplikacji „AI Web Gateway" wraz z określeniem jej funkcjonalności, wymagań technicznych oraz potencjalnych kierunków rozwoju. Kluczowym problemem badawczym jest sprawdzenie skuteczności zastosowania metod uczenia maszynowego w detekcji wybranych ataków aplikacyjnych oraz analiza ograniczeń związanych z jakością i reprezentatywnością danych treningowych. Ważnym aspektem badań jest także integracja systemu z istniejącymi narzędziami do wizualizacji i raportowania zdarzeń bezpieczeństwa, co ma na celu ułatwienie pracy zespołom zajmującym się obsługą incydentów.
Projektowana aplikacja została oparta na narzędziu mitmproxy, które umożliwia przechwytywanie i modyfikowanie ruchu HTTP/HTTPS w czasie rzeczywistym. W warstwie analitycznej zastosowano metody uczenia maszynowego, w tym regresję logistyczną jako podstawową technikę klasyfikacyjną. W celu zapewnienia przenośności i łatwości wdrożeń całość rozwiązania została skonteneryzowana z użyciem technologii Docker, z możliwością uruchomienia w chmurze Microsoft Azure. Rozważono również integrację z narzędziami klasy Grafana i ELK Stack do analizy logów oraz potencjalną rozbudowę o integrację z systemami SIEM.
Praca składa się z czterech głównych rozdziałów. Rozdział pierwszy zawiera cele i założenia pracy, definiuje system IDPS oraz przedstawia cele projektowe. Rozdział drugi obejmuje analizę wymagań aplikacji, w tym przegląd istniejących rozwiązań takich jak Snort i Suricata, opis person marketingowych, wymagania funkcjonalne i pozafunkcjonalne, cele cyberbezpieczeństwa, analizę struktury i metod ataków oraz przegląd aktualnych algorytmów sztucznej inteligencji. Rozdział trzeci dotyczy implementacji aplikacji IDPS „AI Web Gateway" i zawiera opis doboru technologii i bibliotek, omówienie modelu danych i wyboru metody uczenia, wizję realizacji projektu wraz ze schematem architektury, wyniki testów penetracyjnych, implementację wtyczki oraz proces konteneryzacji. Rozdział czwarty stanowi podsumowanie, w którym przedstawiono wnioski projektowe, oceniono stan projektu i możliwości jego rozwoju, a także przeanalizowano wpływ sztucznej inteligencji na zagrożenia w cyberprzestrzeni oraz możliwe do zastosowania rozwiązania z tej dziedziny.
Praca została przygotowana w oparciu o literaturę zarówno polsko-, jak i anglojęzyczną, ze szczególnym uwzględnieniem źródeł zagranicznych. Wykorzystano publikacje naukowe dotyczące sztucznej inteligencji w cyberbezpieczeństwie, materiały konferencyjne, artykuły z czasopism branżowych oraz raporty badawcze. Ze względu na charakter pracy projektowej istotnym elementem źródeł była dokumentacja techniczna narzędzi wykorzystanych w projekcie, jak również zasoby elektroniczne obejmujące repozytoria open-source, dokumentacje API oraz przykładowe zestawy danych do trenowania modeli uczenia maszynowego.
1. Cele i założenia pracy
Poniższy rozdział poświęcony został badaniom obecnych rozwiązań w zakresie ochrony i monitoringu aplikacji webowych za pomocą analizy istniejących rozwiązań, zdefiniowaniu person marketingowych, oraz przygotowaniu wymagań funkcjonalnych i pozafunkcjonalnych projektu aplikacji IDPS.
Wszystkie zadania wykonane w tym rozdziale mają na celu przygotowanie wymagań do implementacji aplikacji IDPS zatytułowanej „AI Web Gateway", która zostanie przedstawiona w Rozdziale 2.
1.1. Definicja systemu IDPS
System IDPS, z angielskiego Intrusion Detection & Prevention System, to aplikacja, która przechwytuje komunikację sieciową między użytkownikiem a serwerem i poddaje analizie zawartość pakietów pod kątem szkodliwej zawartości w celu ochrony integralności, poufności i dostępności zasobów informatycznych.
IDPS składa się z dwóch komponentów: IDS oraz IPS. Komponent IDS pełni funkcję analityczną, która decyduje, czy dany ruch jest szkodliwy, a następnie informuje odpowiednie systemy, takie jak IPS, serwery logów, czy systemy SIEM, o wystąpieniu incydentu.[^1]
IPS odpowiada za zneutralizowanie zagrożenia po otrzymaniu informacji o jego wystąpieniu w infrastrukturze systemowej. Neutralizacja zagrożenia może przebiegać na kilka sposobów: możliwe jest usunięcie podejrzanej sygnatury z ruchu, rekonfiguracja infrastruktury w celu uniemożliwienia podjęcia kolejnych akcji, lub też po prostu przechwycenie i zablokowanie kontynuacji ścieżki pakietu.[^2]
1.2. Cele projektowe
Autor niniejszej pracy magisterskiej za główne cele projektowe uważa stworzenie dowodu słuszności koncepcji, poprzez wytrenowanie modelu zdolnego przechwycić większość podstawowych ataków skierowanych do aplikacji webowej po protokołach http i https o nazwie „AI Web Gateway".
Obecnie za jedne z najpopularniejszych ataków uznaje się ataki wstrzykujące, typu Command Injection, SQL Injection oraz Cross-Site Scripting — według listy OWASP Top 10, organizowanej przez OWASP Foundation, zajmują one 3 miejsce wśród najczęstszych ataków.[^3]
2. Analiza Wymagań Aplikacji
2.1. Przegląd istniejących rozwiązań
Autor projektu rozpoczął pracę od zbierania wymagań na podstawie istniejących rozwiązań — dobrze przeprowadzona analiza konkurencji ułatwia identyfikację kluczowych cech produktu, a także unikalnych punktów sprzedaży w przypadku rozwiązań komercyjnych.
2.1.1. Snort
Otwartoźródłowe oprogramowanie IDPS z bogatą konfiguracją, utworzone jako projekt społeczności Sourcefire, następnie wykupione przez Cisco. Oferuje prosty interfejs użytkownika. Poza standardowymi funkcjonalnościami IDPS typu blokowanie podejrzanych sygnatur, można go wykorzystać jako rejestrator pakietów.
Rysunek 1. GUI aplikacji Snort. Źródło: blog.snort.org [21.05.2025]
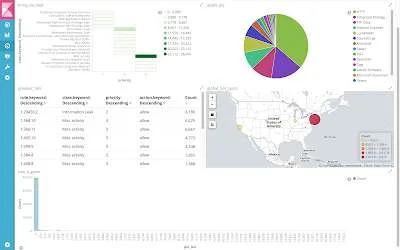
Snort oferowany jest w dwóch wersjach, drugiej i trzeciej. Wersja druga ma większe wsparcie społeczności, ale jako wadę można wyróżnić brak wsparcia dla wielowątkowości, przez co może powodować powstawanie wąskich gardeł w ruchu sieciowym.
Wersja 3 oferuje obsługę nowszych wersji protokołów, przykładowo HTTP/2, a także wspiera tworzenie modułów rozszerzających funkcjonalność narzędzia za pomocą języka skryptowego Lua, jednak nie oferuje pełnego wsparcia dla reguł i konfiguracji z wersji drugiej, oraz nie posiada aż tak rozbudowanej społeczności na ten moment.[^4]
Oprogramowanie posiada wsparcie dla wielu GUI tworzonych przez społeczność, jak również wspiera integracje ze stosem technologicznym ELK[^5], co w obecnych czasach jest standardem cenionym przez wiele firm i instytucji.
2.1.2. Suricata
Utworzona w 2009 roku przez The Open Information Security Foundation, otwartoźródłowa aplikacja IDPS udostępniana na bazie licencji GNU GPL 2; alternatywnie może również pełnić funkcje monitoringu sieciowego.
Rysunek 2. GUI aplikacji Suricata (EveBox). Źródło: suricata.io [21.05.2025]
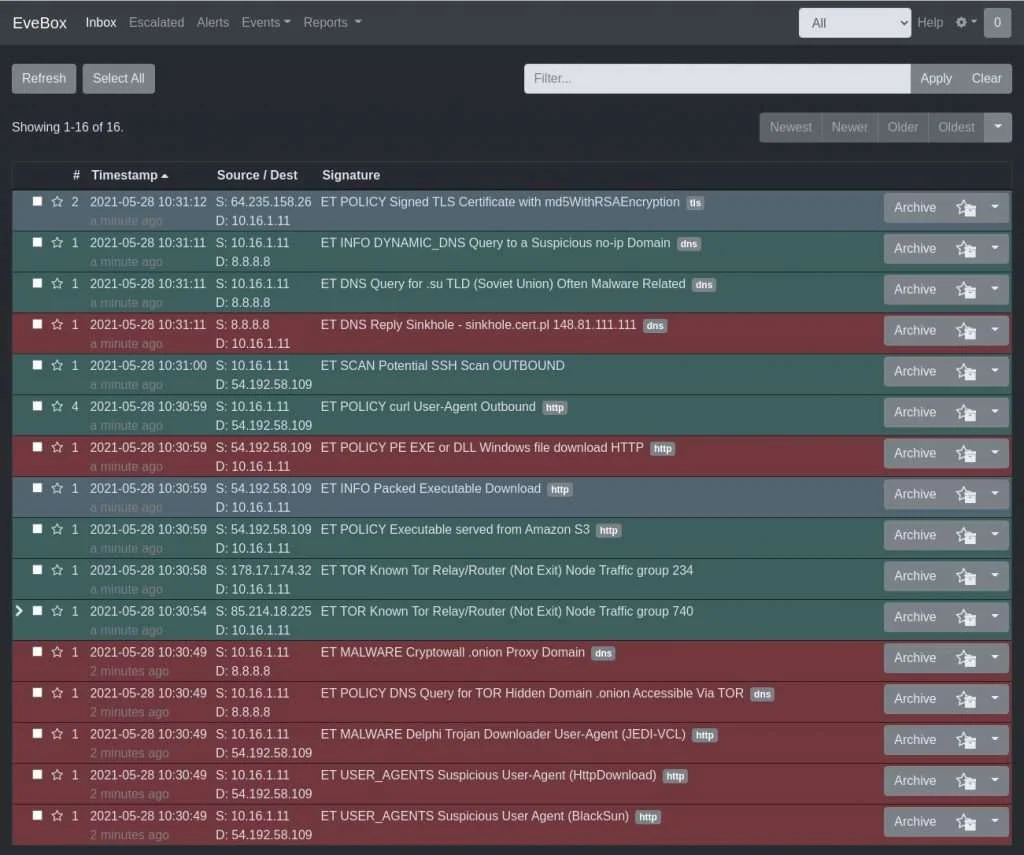
Największą zaletą Suricaty jest zaawansowana technologia wykorzystywana do analizy pakietów — mowa między innymi o głębokiej inspekcji pakietów połączonej z badaniem sygnatur i analizą anomalii, a także analiza certyfikatów TLS.[^6]
Niemniej oprogramowanie posiada też kilka wad, takich jak złożoność konfiguracji, mniejsze wsparcie użytkowników w porównaniu do omawianego Snorta, czy też wysokie wymagania sprzętowe, czyniąc to rozwiązanie przeznaczonym dla większych firm, które mogą sobie pozwolić na większe koszty w zamian za skuteczność.
2.2. Persony Marketingowe
Termin persona marketingowa powstał w latach 80. XX wieku. Jego twórcą był Alan Cooper, który tworząc na podstawie ankiet użytkowników personę nazwaną „Kathy", stworzył w ten sposób fundamenty współczesnej inżynierii wymagań użytkowników.[^7]
Przed zrozumieniem, dlaczego persony marketingowe mają znaczenie, należy przypomnieć główny paradygmat programowania, twierdzący, że głównym celem oprogramowania jest rozwiązywanie problemów, co zostało wielokrotnie wspomniane między innymi przez wcześniej wspomnianego Alana Coopera[^8], czy też „Manifest Agile"[^9], którego sygnatariuszami były osoby mające kluczowy wpływ na dzisiejszy kierunek rozwoju oprogramowania.
Określenie profilu klienta i jego potrzeb, a także problemów, ma kluczowe znaczenie przy projektowaniu produktów informatycznych — pozwala to na stworzenie produktów wysoce spersonalizowanych, a przez to konkurencyjnych na rynku.[^10]
Próba budowy autentycznej persony marketingowej jest procesem złożonym, a jego skuteczność zależy od wielu czynników, takich jak dostęp do danych klientów, regularnie przeprowadzane ankiety, czy też opinie na temat istniejących rozwiązań, dlatego autor niniejszej pracy skupił się przede wszystkim na analizie publicznie dostępnych danych klientów istniejących rozwiązań.
Pierwszą personą, która mogłaby być potencjalnym użytkownikiem aplikacji, jest Dyrektor do spraw bezpieczeństwa informacji. Jest on pracownikiem dużej korporacji oraz posiada kilkanaście lat w branży cyberbezpieczeństwa; jego priorytetem jest spełnianie wielu regulacji, takich jak ISO czy GDPR, a także sprawne zarządzanie budżetem. Motywacją tej osoby może być chęć ochrony danych przedsiębiorstwa oraz zapewnienie ciągłości działania systemów, natomiast problemem może okazać się integracja oprogramowania z zaawansowanym stosem technologicznym firmy oraz presja związana z SLA.[^11]
Kolejną fikcyjną personą, do której może być skierowane oprogramowanie, to menedżer działu informatycznego, działający w firmie średniej wielkości, którego doświadczenie w dziedzinie cyberbezpieczeństwa jest raczej pobieżne i może nie być na bieżąco ze wszystkimi trendami. Jego głównym problemem jest zapewnienie bezpieczeństwa przy minimalizacji kosztów związanych z personelem czy infrastrukturą — potrzebuje on rozwiązania natychmiastowo gotowego do użycia.[^12]
Ostatnią personą zdefiniowaną przez autora jest specjalista do spraw DevSecOps, czyli osoba integrująca ze sobą cykl wytwarzania oprogramowania z operacjami oraz cyberbezpieczeństwem — jako specjalista w swojej dziedzinie, musi mieć możliwość integracji oprogramowania z cyklem CI/CD poprzez narzędzia takie jak Jira czy też Jenkins.[^13]
2.3. Wymagania funkcjonalne i pozafunkcjonalne
Przeprowadzona we wcześniejszym podrozdziale analiza pozwoliła na zdefiniowanie kluczowych cech systemu IDPS, gdzie jako główny czynnik decydujący o doborze rozwiązania uznaje się skuteczność w porównaniu do kosztu rozwiązania, natomiast jako opcjonalne właściwości można uznać modularność czy też nowoczesny interfejs użytkownika.
2.3.1. Wymagania funkcjonalne
- Blokowanie ataków na aplikację internetową po protokole HTTP i HTTPS
- Wykrywanie różnych typów ataków
- Interfejs użytkownika, który ułatwia przeglądanie logów, a także prostą konfigurację aplikacji
Biorąc pod uwagę wyżej wymienioną analizę, autor niniejszej pracy skupił się przy implementacji rozwiązania na optymalizacji skuteczności bez wyraźnego podniesienia kosztów rozwiązania.
2.3.2. Wymagania pozafunkcjonalne
- Aplikacja działa niezależnie od systemu operacyjnego
- Automatyzacja testów penetracyjnych
- Aplikacja powinna być wydajna i nie blokować chronionych zasobów
- System powinien być prosty w utrzymaniu, kod źródłowy podatny na modyfikacje
- Skonteneryzowane środowisko developerskie
- Modularność aplikacji
- Skuteczność wykrywania na poziomie minimum 70%
W obecnych czasach konteneryzacja stała się podstawą większości aplikacji biznesowych, co udowadnia wzrost popularności technologii takich jak Kubernetes czy Docker na przestrzeni ostatnich lat.[^14] Za standard można również uznać automatyzację wszelakich procesów, takich jak testowanie, czy też tworzenie czystego kodu bazującego na paradygmatach i regułach OOP typu SOLID, KISS, czy też DRY.[^15]
2.4. Cele cyberbezpieczeństwa i natura cyfrowych ataków
Przez dekady ciągle przyśpieszającego postępu technologicznego wektory ataku, podatności, jak i systemy ewoluowały; cele osób stojących za atakami na wrażliwe systemy informatyczne nie uległy zbyt dużej zmianie. Rozpoznanie, kto może chcieć zaatakować organizację i dlaczego, jest jednym z ważniejszych kroków przy projektowaniu ochrony cyberprzestrzeni.
2.4.1. Historia rozwoju motywów ataków
Jedne z pierwszych ataków przeprowadzonych na systemy informatyczne były przeprowadzone głównie z ludzkiej ciekawości. Cyberkryminaliści tacy jak Kevin Mitnick eksplorowali zabezpieczenia swoich dostawców usług sieciowych, przeprowadzali ataki socjotechniczne, żeby sprawdzić, co mogą osiągnąć za pomocą wiedzy informatycznej oraz rozrywki.[^16]
Na przestrzeni kolejnych lat rozwinęły się kolejne motywy hakerskie, takie jak chęć uzyskania korzyści materialnych, szpiegostwa oraz sabotażu przemysłowego — te przyczyny do dnia dzisiejszego są jednymi z najpopularniejszych przyczyn stojących za atakami na infrastrukturę prywatną czy też publiczną.
Ze względu na wzrost popularności cyberataków i cyberbezpieczeństwa, a także poprzez popularyzację zaawansowanych systemów komputerowych na przestrzeni ostatnich lat, pojawiły się bardziej intrygujące motywy przewodnie ataków, chociażby haktywizm na przykładzie grupy „Anonymous", która wielokrotnie działała w różnych rejonach świata, próbując przeciwdziałać próbom ograniczenia wolności słowa poprzez ataki na infrastrukturę państwową.
Wzrost popularności w sferze publicznej przełożył się również na zainteresowanie wśród większości państw tematem cyberbezpieczeństwa — coraz więcej państw powołuje w swoich strukturach wojskowych specjalne komponenty do spraw cyberbezpieczeństwa, zabezpieczające kluczową infrastrukturę[^17], począwszy od zakładów energetycznych, aż po łączność satelitarną i komunikację. Analogicznie do cyberbezpieczeństwa rozwinęły się też techniki wywiadowcze oparte na atakach w sferze cyfrowej, a także nieoficjalne finansowanie przez państwa grup hakerskich, oficjalnie określanych jako APT, z angielskiego „advanced persistent threat"[^18], zajmujących się długotrwałym infiltrowaniem infrastruktury rywalizujących bądź wrogich państw.
Ostatnią przyczyną, dla której przeprowadzane są ataki, jest cyberterroryzm, który dopiero zyskuje na popularności wśród grup terrorystycznych — idee są zbliżone do haktywizmu, jednak same ataki częściej są wymierzone w osoby postronne, takie jak ludność cywilna, poprzez ataki na infrastrukturę krytyczną, taką jak szpitale, zakłady energetyczne, czy też sektor finansowy.
2.4.2. Cele Cyberbezpieczeństwa
Celem nadrzędnym cyberbezpieczeństwa jest ochrona zasobów organizacji przed nieupoważnionym dostępem, modyfikacją lub też utratą dostępu do zasobu przez osoby upoważnione — jest to tak zwany model triady CIA, z angielskiego „Confidentiality – Integrity – Availability".[^19]
Przez lata funkcjonowania tej dziedziny został wypracowany model „ochrony w głąb", nazywany też często modelem cebuli, oznaczający, że przy każdej warstwie systemu należy umieścić usługę chroniącą daną warstwę przed próbami ataku. Najczęściej odwołuje się to do warstw modelu ISO/OSI, czyli siedmiowarstwowej struktury ruchu sieciowego, jednak to nie jedyna możliwość podziału, którymi można się kierować — sam model cebuli można zastosować w głębszych warstwach, chociażby systemu operacyjnego.[^20]
Powyższy model jednak nie jest idealny, co zmusiło specjalistów od cyberbezpieczeństwa do poszukiwania nowszych architektur. Jedną z nich jest architektura siatki cyberbezpieczeństwa, która nakłania do stosowania perymetru ochrony per zasób, zamiast warstwy, utrudniając przeprowadzenie skutecznego ataku — architektura ta komponuje się z architekturą mikroserwisową, coraz częściej stosowaną w organizacjach, umożliwiając szybsze wprowadzanie zmian.[^21]
Warto wspomnieć, że powyższe architektury to nie jedyne używane w cyberbezpieczeństwie — powstało również wiele frameworków, mających za zadanie ułatwić implementację zabezpieczeń w przedsiębiorstwach i organizacjach.
Jednym ze starszych i często stosowanych na całym świecie jest norma ISO 27001, często też nazywana ISMS, z angielskiego Information Security Management Systems. Definiuje ona bezpieczeństwo informacji i skupia zabezpieczenia wokół czterech filarów: organizacji, osób, bezpieczeństwa fizycznego, a także technologicznego.[^22]
2.5. Analiza obecnych zagrożeń w cyberbezpieczeństwie
W dzisiejszych czasach zagrożenia w cyberprzestrzeni zmieniają się w sposób ciągły — ze względu na dynamikę w rozwoju technologii informatycznych, każda nowa biblioteka, nowe urządzenia czy też nowe algorytmy wpływają na istniejące zagrożenia lub też tworzą nowe.
Rozwój algorytmów sztucznej inteligencji również zwiększył liczbę zagrożeń poprzez dołożenie nowych wektorów ataku, automatyzację skryptów, czy też tworzenie tak zwanych „Deep Fake", czyli bardzo realistycznych podróbek głosu czy też wideo, dlatego autor niniejszej pracy zwraca uwagę, jak ważne jest wykonanie prawidłowej analizy ryzyka i zagrożeń przed przystąpieniem do próby implementacji mechanizmów obronnych.
2.5.1. Struktura ataku
Pierwszą z faz, które należy wykonać przed przystąpieniem do ataku, jest przeprowadzenie rozpoznania. Ta faza jest zazwyczaj legalna, ze względu na brak wykonania trwałych lub tymczasowych akcji naruszających zabezpieczenia przedsiębiorstwa, dlatego też często jest przezywana „Białym Wywiadem", rekonesansem, lub też skrótem OSINT. W trakcie wykonywania tych czynności zbierane są wszelkie informacje, które mogą być przydatne do przeprowadzenia ataku — mogą to być między innymi: informacje o pracownikach, dostępne publicznie usługi, adresy internetowe, wpisy na profilach społecznościowych lub też fizyczne lokalizacje.[^23]
Następnie podmiot atakujący przystępuje do „uzbrojenia" zebranych informacji. Polega to na wykorzystaniu znalezionych informacji na temat celu do przygotowania ataku — między innymi może to być stworzenie maila phishingowego, stworzenie podrobionej strony organizacji, lub też wykorzystanie luk w istniejących podatnościach do przygotowania oprogramowania, mającego na celu wykorzystanie podatności.[^24]
Faza trzecia skupia się na dostarczeniu zainfekowanych artefaktów do odbiorcy, którym może być zarówno osoba fizyczna, jak i system. Po dostarczeniu artefaktu podmiot atakujący najczęściej oczekuje na wykonanie akcji po stronie odbiorcy — może to być przykładowo kliknięcie w zainfekowany załącznik, wejście na podrobioną stronę, czy też wykonanie skryptu przez serwer. Po wykonaniu akcji powstaje okno czasowe, w trakcie którego atakujący uzyskuje dostęp do systemu, wykorzystując uprawnienia odbiorcy.[^25]
Kolejna faza zakłada wykorzystanie uprawnień odbiorcy do eksploracji wewnętrznej sieci, wykrycia, jakie odbiorca ma możliwości, i skanowania wewnętrznych podatności, które w większości przypadków są łatwiejsze do wykorzystania lub jest ich więcej — jest to faza zbliżona do pierwszej.
Moment, w którym atakujący posiada większą świadomość o wewnętrznym systemie odbiorcy ataku, jest wykorzystywany do stworzenia wejścia awaryjnego dla podmiotu atakującego — może to być przykładowo stworzenie konta użytkownika, stworzenie tunelu umożliwiającego połączenie po protokole SSH. Takie wejście nazywane jest „persistent backdoor" i daje atakującemu możliwość wejścia do atakowanego systemu już bez interakcji odbiorcy ataku.[^26]
Przedostatnia faza nazywana jest sprawowaniem dowodzenia i kontroli, jako że skupia się na wykonywaniu komend i skryptów, które mają na celu zbliżenie atakującego do osiągnięcia celu ataku — mowa tu między innymi o przejmowaniu kolejnych części systemu, podszywaniu się za innych użytkowników lub szyfrowaniu plików.
Końcowa faza jest równoznaczna z częściowym lub całkowitym osiągnięciem przez atakującego wyznaczonych celów i przystąpieniem do wykorzystania ich na swoją korzyść — może to być zażądanie okupu, sprzedaż poufnych informacji, lub po prostu wyłączenie lub zniszczenie konkurencyjnego systemu.
2.5.2. Najpopularniejsze metody ataku
W związku z ciągle rosnącą ilością ataków przeprowadzanych na wszelkiego rodzaju podmioty, powstało wiele fundacji zajmujących się zbieraniem danych o atakach oraz analizą tych ataków i rozpowszechnianiem wiedzy o najpopularniejszych wektorach ataków. Najpopularniejszym wśród nich jest OWASP Foundation, regularnie publikujące swoją listę „Top 10"[^27], zawierającą najpopularniejsze ataki na aplikacje internetowe. Drugą z nich jest Mitre Corporation, zajmująca się ciągłym utrzymywaniem i aktualizacją listy „ATT&CK"[^28], zawierającej najpopularniejsze techniki wykorzystywane w poszczególnych fazach ataków.
Autor niniejszej pracy postanowił zebrać kilka z najpopularniejszych i wstępnie je przedstawić dla szerszego zrozumienia:
- SQL Injection — atak polegający na dodaniu własnego wyrażenia SQL do pola z interfejsu użytkownika, pozwala to na wybranie, modyfikację oraz usunięcie danych, do których podmiot nie powinien mieć dostępu.[^29]
- Cross-Site Scripting — podatność, która pozwala na umiejscowienie skryptu JavaScript przez atakującego na stronie aplikacji; można do tego wykorzystać pola w interfejsie użytkownika, ale też obrazy, ukrywając w nich fragmenty kodu — taki kod w następstwie wykonuje się po stronie każdego klienta ładującego stronę.
- Phishing — atak polegający na podszywaniu się pod zaufane podmioty, wykorzystujący popularne kanały dystrybucji, takie jak mail czy też SMS, do dostarczenia zainfekowanych artefaktów lub też wyłudzenia danych poufnych.[^30]
- Command Injection — analogicznie do SQL Injection, wykorzystuje pola w interfejsie użytkownika wykonujące programy na serwerze, do wykonania poleceń zleconych przez podmiot atakujący; w tym celu najczęściej stosowane jest łączenie komend.
- Replikacja przez nośnik wymienny — zakłada wykorzystanie funkcji automatycznego uruchamiania na nośniku wymiennym typu pendrive, czy też płyta CD, do uruchomienia szkodliwego oprogramowania na maszynie użytkownika.[^31]
Powyższa lista prezentuje tylko kilka z wielu możliwych technik używanych w atakach hackerskich, obrazując, jak ważne jest zabezpieczenie systemu na wielu płaszczyznach. Warto również polegać na wielu rodzajach zabezpieczeń, jako że niektóre podatności mogą wynikać z przestarzałego oprogramowania, czy też z czynnika ludzkiego.
2.6. Przegląd obecnych algorytmów sztucznej inteligencji
Ostatnie lata spopularyzowały rozwój uczenia maszynowego i sztucznej inteligencji w coraz większej ilości obszarów, powodując powstanie dużej liczby algorytmów, które można zastosować w wielu dziedzinach — nie inaczej jest w przypadku cyberbezpieczeństwa, gdzie coraz większa liczba technologii jest używana do ataków i zabezpieczania systemów:
- Regresja liniowa — metoda statystyczna służąca do modelowania zależności liniowej między zmiennymi i przewidywania wartości ciągłej; można ją wykorzystać do analizy trendów, zarówno w kontekście biznesowym, jak i do przewidywania ruchu w komunikacji sieciowej i jako składowa algorytmów wykrywania anomalii.
- Regresja logiczna — technika klasyfikacji skupiająca się na przewidywaniu prawdopodobieństwa należności danej do jednej z dwóch klas; tymi klasami mogą być konkretne encje, ale również możliwa jest klasyfikacja typu tak lub nie, przydatna do detekcji chociażby phishingu.
- Drzewa decyzyjne — model oparty o węzły i liście, w którym każdy liść może określać klasę, natomiast węzły odpowiadają za wykonanie operacji w oparciu o cechę; dobrze sprawdzają się przy niewielkiej ilości cech i klas, mogą wchodzić w skład bardziej zaawansowanych modeli jak „Random Forest".
- Klastrowanie — nienadzorowana metoda służąca do grupowania danych w klastry o podobnych właściwościach, szczególnie przydatna przy segmentacji i identyfikacji danych.
- Sieci neuronowe — zaawansowana technika klasyfikacji wchodząca w skład metod uczenia głębokiego, pozwala na przetwarzanie skomplikowanych wzorców i analiz, jednak wymaga dużych zasobów i danych do nauki, a także są ciężkie w interpretacji.
- SVM — nadzorowana metoda klasyfikacji korzystająca z kerneli do znalezienia optymalnej hiperpłaszczyzny; dobrze odnajduje się w zbiorach zawierających wielowymiarowe cechy, a także jest w dużym stopniu odporna na przeuczenie, jednak jest kosztowna obliczeniowo.
- Reguły asocjacyjne — algorytm oparty o probabilistykę, wyliczający szansę na wystąpienie danej, jeśli warunki poprzedzające są spełnione; jest prosty w implementacji, jednak bardzo ciężki w utrzymaniu przy dużych ilościach warunków.
- Autoenkodery — rozwinięte sieci neuronowe posiadające przestrzeń latentną, bardzo dobrze sprawdzają się w rekonstrukcji, jednak analogicznie do sieci neuronowych są ciężkie do interpretacji oraz wymagają dużych zbiorów danych do nauki.
- Q-Learning — algorytm uczenia przez wzmocnienie, skupiony na zasadzie nagrody i kary, wybierający działania oferujące największą nagrodę, co pozwala mu na adaptację do nowych wzorców na podstawie wyznaczonych reguł, jednak jego czas reakcji jest opóźniony w porównaniu do innych modeli, a także nie skaluje się wydajnie, jednak jest używany w wielu bardziej zaawansowanych technikach, takich jak DQN.
Powyższa lista prezentuje jedne z najbardziej popularnych, podstawowych technik używanych w dziedzinie uczenia maszynowego, jednak nie jest ona kompletna — nowe techniki powstają w błyskawicznym tempie, również starsze modele są wielokrotnie łączone w bardziej kompleksowe modele, osiągając przy tym wyższą skuteczność.[^32]
3. Implementacja Aplikacji IDPS „AI Web Gateway"
Posiadając informacje na temat wymagań funkcjonalnych i pozafunkcjonalnych aplikacji, rozwiązań konkurencyjnych, a także obecnie stosowanych rozwiązań, należy przystąpić do doboru technologii do projektu i jego implementacji.
3.1. Wybór technologii i opis bibliotek
Kluczowym dla każdego projektu informatycznego jest dobór odpowiedniego stosu technologicznego do zadania, które ma wykonywać. W dalszej części tego podrozdziału prezentowany jest spis głównych technologii i bibliotek wykorzystanych do stworzenia aplikacji.
Autor niniejszego projektu zdecydował się na użycie języka programowania Python do implementacji aplikacji, ze względu na dostępne biblioteki, prostą składnię, popularność społeczności zajmującej się cyberbezpieczeństwem, jak i własne doświadczenie w tym języku.
Jedną z kluczowych bibliotek dla projektu jest biblioteka MitmProxy, która implementuje zestawianie tunelu z użyciem protokołów SSL/TLS, w którym używa implementacji ataku man-in-the-middle w celu przeglądania zaszyfrowanego ruchu, a także oferuje internetowy interfejs użytkownika oraz modularność poprzez obsługę wtyczek pisanych w języku Python.[^33]
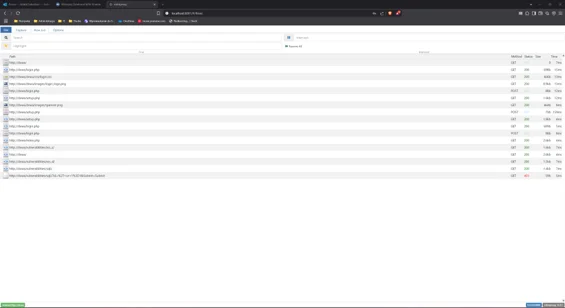
Rysunek 3. Przeglądarka logów biblioteki MITMProxy. Źródło: opracowanie własne.
Biblioteka SciKit-Learn odpowiedzialna była za dostarczenie gotowych do nauki algorytmów uczenia maszynowego, takich jak regresja logiczna, które zostały użyte do stworzenia modelu na podstawie danych.[^34]
Projekt był przechowywany za pomocą narzędzia do kontroli wersji GIT na repozytorium GitHub, zapewniając możliwość powrotu do poprzednich wersji projektu, a także ułatwiając prowadzenie przyrostowych prac nad kodem aplikacji oraz podgląd historii zmian plików.
Za realizację „reverse proxy" odpowiada serwer webowy NGINX, stabilne i w dużym stopniu konfigurowalne oprogramowanie, zawierające wiele przydatnych funkcji, wsparcie dla wielu systemów operacyjnych, oraz mnogość rozszerzeń.[^35]
Celem do ochrony została aplikacja webowa DVWA, zaimplementowana przez społeczność GitHub jako oprogramowanie do nauki cyberbezpieczeństwa i testów penetracyjnych. Aplikacja posiada celowo przygotowane luki, które można wykorzystać, co umożliwiło przetestowanie działania aplikacji IDPS pod tytułem „AI Web Gateway" bez konieczności implementacji własnej aplikacji frontend.[^36]
Rysunek 4. Interfejs aplikacji DVWA. Źródło: opracowanie własne.
Za konteneryzację oprogramowania i całej infrastruktury odpowiada jedna z popularniejszych i ciągle rozwijanych aplikacji do konteneryzacji o nazwie Docker, wraz z menedżerem windowsowym Docker Desktop oraz deklaratywną konfiguracją środowiska za pomocą plików napisanych w języku YAML o nazwie Docker-compose.[^37]
3.2. Model
Przed przystąpieniem do implementacji modelu, należy wykonać przegląd danych i ich interpretację, aby wiedzieć, na jakich danych model będzie się uczył, i dobrać najlepszy do danego zadania — zgodnie z podpunktem 2.6, każdy model ma swoje mocne i słabe strony.
3.2.1. Dane
Dane do projektu zostały zaczerpnięte ze strony Kaggle, oferującej otwartoźródłowe zbiory danych do trenowania modeli. Jest to najczęściej wykorzystywana strona do prowadzenia badań i rozwoju sztucznej inteligencji, jednak o ile dane te pozwalają na udowodnienie koncepcji, do rozwiązań komercyjnych zwykle stosuje się dane prywatne przedsiębiorstw, które ciężko jest zdobyć.
Tabela 1. Fragment danych treningowych modelu. Źródło: kaggle.com [26.07.2025]
| Zapytanie | Etykieta |
|---|---|
? or 1 = 1 -- |
1 |
2689 |
0 |
<div draggable="true" contenteditable>drag me</div><content ondrop=alert(1) contenteditable>drop here</content> |
1 |
</span><link rel="mw-deduplicated-inline-style" href="mw-data:TemplateStyles:r935243608"/> |
0 |
Format danych do uczenia nadzorowanego składa się z kolumn cech oraz etykiety, która determinuje, czy dany zbiór cech zalicza się do klasy czy nie — w przypadku modelu do IDPS jest to jedna cecha, jest nią zapytanie, które w ramach normalizacji danych zostanie rozbite na mniejsze części. Przykładowy fragment danych prezentuje Tabela 1.
3.2.2. Interpretacja danych
Zbiór danych złożony jest z 3 typów ataków oraz danych prawidłowych: dla SQL Injection zostało przygotowane 30 tysięcy rekordów, dla Cross-Site Scripting w przybliżeniu 15 tysięcy, najmniejszy zbiór zawiera ataki Command Injection w liczbie 2 tysięcy. Model po treningu na takim zbiorze nie powinien mieć problemu z rozpoznawaniem SQL Injection czy XSS, ale ze względu na wielkość zbioru Command Injection mogą pojawić się problemy z wykrywaniem tego typu ataków.
Rozkład danych oznaczonych jako atak, czyli zawierających etykietę 1, w porównaniu do prawidłowego ruchu, oznaczonego etykietą 0, jest bliski równowagi, więc model powinien być w stanie dobrze rozróżniać ruch prawidłowy od szkodliwego.
W przypadku klasyfikacji danych ciąg znaków najczęściej jest rozbijany na mniejsze ciągi, a następnie wektoryzowany, tworząc słownik wyrażeń, które model zna. W przypadku obecnego modelu może to spowodować, że model, napotykając wzór ataku, który nie zawiera żadnego znanego słowa, nie rozpozna takiego ataku — istnieje jednak sposób na rozwiązanie tego problemu, zostanie on przedstawiony w ramach podsumowania projektu.[^38]
3.2.3. Wybór metody
Niniejszy projekt korzysta z regresji logistycznej do wykrywania wzorców ataków, ze względu na szybkość, łatwość w interpretacji przy zachowaniu wysokiej skuteczności. Są to bardzo ważne cechy w systemach typu IDPS.[^39]
Rozważane były jeszcze modele takie jak SVM i drzewa decyzyjne, jednak ich skuteczność jest w większości porównań niższa, a także koszty implementacji nieporównywalnie wyższe.[^40]
Ostatnim aspektem, który przeważył przy wyborze modelu, była możliwość rozbudowy w bardziej skuteczne rozwiązania — udowodniono przypadek, gdzie dla urządzeń Internetu Rzeczy uzyskano skuteczność na poziomie ponad 99% na zbiorze testowym przy rozbudowanej regresji logistycznej w ramach aplikacji IDS.[^41]
3.3. Wizja realizacji projektu
Projekt realizowany był w sposób przyrostowy, co pozwoliło na dostosowanie oprogramowania do wymagań interesariuszy, lepsze wykrywanie błędów, a także szybsze dostarczanie działającej wersji oprogramowania.
3.3.1. Schemat architektury aplikacji
Naturalnym dla aplikacji typu IDPS jest bycie wpiętym jako odwrotny pośrednik do serwera aplikacji internetowej, pozwala to na ukrycie serwera przed klientami i nadzór nad ruchem przychodzącym do serwisu.[^42]
Rysunek 5. Schemat architektury sieciowej aplikacji. Źródło: opracowanie własne. Schemat przedstawia dwóch użytkowników (Threat Actor oraz Użytkownik Aplikacji Webowej) łączących się przez swoje routery i Internet do punktu wejściowego (EntryPoint), za którym w ramach jednego poda docker-compose znajdują się kolejno: reverse proxy NGINX, aplikacja IDPS oraz aplikacja DVWA.
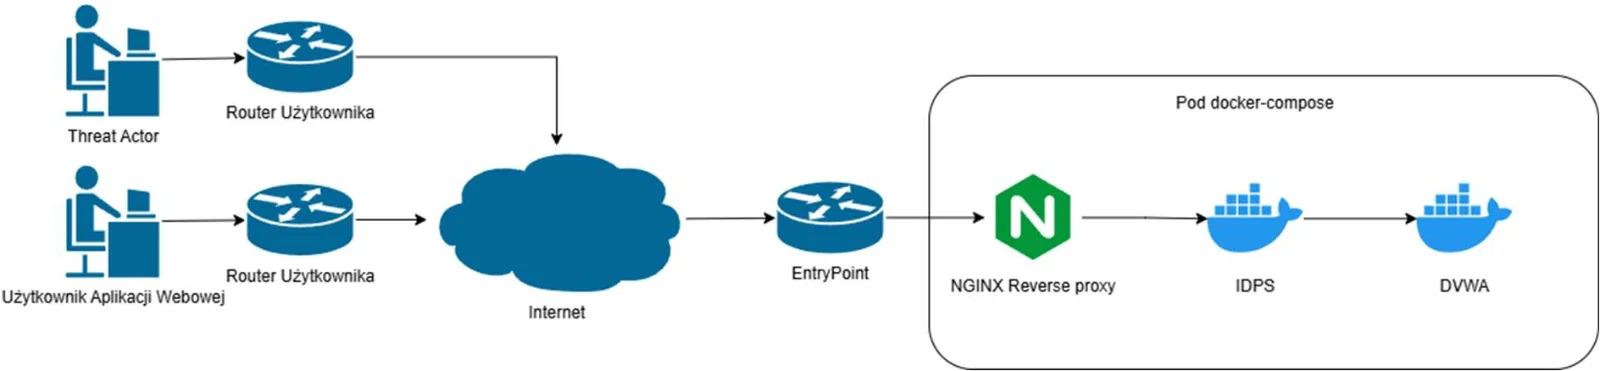
Autor niniejszego projektu zdecydował się na wydzielenie serwera świadczącego obsługę odwrotnego pośrednika do osobnego kontenera, zgodnie z architekturą zaprezentowaną na Rysunku 5, ze względu na zmniejszenie rozmiaru obrazów, łatwiejsze skalowanie kontenerów IDPS, zmniejszenie wektora ataku, jak również szybsze uruchamianie kontenerów — jednak możliwe jest, żeby IDPS jednocześnie pełnił funkcję odwrotnego pośrednika i pracował na obrazie NGINX.[^43]
3.3.2. Testy penetracyjne
Kolejnym krokiem w implementacji oprogramowania, gdy już zespół wytwórczy posiada wymagania i technologie potrzebne do realizacji projektu, powinno być przygotowanie scenariuszy testowych.
Tabela 2. Przypadki testowe do testów penetracyjnych. Źródło: opracowanie własne.
| L.P. | Ładunek | Typ ataku | Oczekiwane | Rezultat | Status |
|---|
| 1 | `1 UNION SELECT null, username | | '~' | | password FROM users --` | SQLI | 403 | 403 | Pozytywny |
| 2 | 105' OR 1=1 | SQLI | 403 | 200 | Negatywny |
| 3 | ' OR EXISTS(SELECT * FROM users WHERE username='admin') -- | SQLI | 403 | 403 | Pozytywny |
| 4 | '; EXEC xp_cmdshell('dir'); -- | SQLI | 403 | 403 | Pozytywny |
| 5 | ' AND SLEEP(5) -- | SQLI | 403 | 403 | Pozytywny |
| 6 | " OR "" = " | SQLI | 403 | 403 | Pozytywny |
| 7 | abc | SQLI | 200 | 200 | Pozytywny |
| 8 | 105 | SQLI | 200 | 200 | Pozytywny |
| 9 | 1 ORDER BY 10 -- | SQLI | 403 | 403 | Pozytywny |
| 10 | 1; SHUTDOWN -- | SQLI | 403 | 200 | Negatywny |
| 11 | <iframe src='javascript:alert(1)'></iframe> | XSS | 403 | 403 | Pozytywny |
| 12 | <body onload=alert('test')> | XSS | 403 | 403 | Pozytywny |
| 13 | <math><mi>x</mi><mtext><svg onload=alert(1)></svg></mtext></math> | XSS | 403 | 403 | Pozytywny |
| 14 | <div onmouseover=alert(1)>XSS</div> | XSS | 403 | 403 | Pozytywny |
| 15 | ";alert(1);// | XSS | 403 | 403 | Pozytywny |
| 16 | Welcome back! | XSS | 200 | 200 | Pozytywny |
| 17 | <a href='http://example.com'>Click me</a> | XSS | 200 | 200 | Pozytywny |
| 18 | XSS | XSS | 200 | 200 | Pozytywny |
| 19 | <b>bold</b> | XSS | 200 | 200 | Pozytywny |
| 20 | <img src='x' onerror='console.log(1)'> | XSS | 403 | 200 | Negatywny |
| 21 | 8.8.8.8; rm -rf / | CMDI | 403 | 200 | Negatywny |
| 22 | 127.0.0.1 && sleep 5 | CMDI | 403 | 403 | Pozytywny |
| 23 | `localhost | whoami` | CMDI | 403 | 200 | Negatywny |
| 24 | ;echo vulnerable | CMDI | 403 | 200 | Negatywny |
| 25 | 192.168.1.1 | CMDI | 200 | 200 | Pozytywny |
| 26 | 127.0.0.1 | CMDI | 200 | 403 | Negatywny |
| 27 | 8.8.4.4 | CMDI | 200 | 200 | Pozytywny |
| 28 | ;ping -c 4 evil.com | CMDI | 403 | 200 | Negatywny |
| 29 | ` | | ls` | CMDI | 403 | 403 | Pozytywny |
| 30 | ` | id` | CMDI | 403 | 403 | Pozytywny |
Przypadki przedstawione w Tabeli 2 są złożone z realnych danych, które mogą być wprowadzone, jak i danych, które można uznać za szkodliwe — dane te nazywane są ładunkiem. Dalej w kolejności reprezentowany jest typ ataku, jak i punkt końcowy, do którego trafi ładunek, oczekiwany oraz otrzymany kod odpowiedzi HTTP; ostatnia kolumna jest wynikiem testu — jeżeli kod oczekiwany jest zbieżny z otrzymanym, status testu jest pozytywny, w przeciwnym wypadku wynik testu jest negatywny i wymaga dopracowania modelu.[^44]
Przygotowany ładunek jest prosty, ze względu na to, że aplikacja ma za zadanie udowodnić koncepcję wykorzystania modeli sztucznej inteligencji — do zastosowań komercyjnych testy należy rozszerzyć o większą ilość przypadków, a także bardziej wyrafinowane metody przeprowadzania powyższych typów ataku.
Listing 1. Konfiguracja testów penetracyjnych pliku pentest.py. Źródło: opracowanie własne.
import requests

BASE_URL = "http://localhost"
TIMEOUT = 5

# === 1. Zdefiniowane testy: (payload, funkcja, oczekiwany_kod_statusu) ===

tests = [
    # Tabela przypadków testowych
]
Listing 1 przedstawia wstępną konfigurację testów penetracyjnych oraz import wymaganej biblioteki wewnętrznej Python o nazwie requests[^45], służącej do wykonywania zapytań HTTP. Kolejnym krokiem było zdefiniowanie wstępnej konfiguracji, w której wydzielona została podstawa ścieżki adresowej, czyli maszyna hostująca — w tym przypadku jest to lokalna maszyna, jednak w bardziej zaawansowanych środowiskach może być to inny host. Zdefiniowanie globalnego czasu oczekiwania przed przerwaniem jest dobrą praktyką, o ile w przypadku lokalnego środowiska nie ma mowy o niedostępności, to w przypadku bardziej zaawansowanych środowisk może takie zjawisko wystąpić. Ostatnią definicją jest lista przypadków testowych, deklarowana zgodnie z Tabelą 2.
Listing 2. Zdefiniowanie metod testowych w pliku pentest.py. Źródło: opracowanie własne.
def sqli(payload: str) -> int:
    endpoint = f"{BASE_URL}/vulnerabilities/sqli/"
    params = {"id": payload, "Submit": "Submit"}
    resp = requests.get(endpoint, params=params, timeout=TIMEOUT)
    return resp.status_code

def xss(payload: str) -> int:
    endpoint = f"{BASE_URL}/vulnerabilities/xss_r/"
    params = {"name": payload, "Submit": "Submit"}
    resp = requests.get(endpoint, params=params, timeout=TIMEOUT)
    return resp.status_code

def cmdi(payload: str) -> int:
    endpoint = f"{BASE_URL}/vulnerabilities/exec/"
    data = {"ip": payload, "Submit": "Submit"}
    resp = requests.post(endpoint, data=data, timeout=TIMEOUT)
    return resp.status_code

method_map = {
    "sqli": sqli,
    "xss": xss,
    "cmdi": cmdi,
}
Dalszym etapem było opracowanie metod testowych dla poszczególnych punktów końcowych, przedstawione na Listingu 2, oraz zmapowanie ciągu znaków z tabeli przypadków na konkretną metodę testową.
Każda metoda przyjmowała ciąg znaków, który następnie wysyłała na endpoint zbudowany z bazowego adresu oraz ścieżki dostosowanej do typu ataku, w odpowiedzi metoda zwracała kod HTTP zwrócony przez usługę. Taka implementacja pozwoliła na bardziej generyczne zbudowanie test runner'a, czyli metody odpowiedzialnej za wykonywanie konkretnych przypadków.
Listing 3. Implementacja test runnera w pliku pentest.py. Źródło: opracowanie własne.
def run_tests():
    total = len(tests)
    correct = 0
    failed_cases = []

    print("\n=== Running tests ===\n")
    for i, (payload, method_name, expected_status) in enumerate(tests, 1):
        test_func = method_map[method_name]
        try:
            actual_status = test_func(payload)
            match = actual_status == expected_status
            if match:
                correct += 1
                status = "[OK]"
            else:
                status = "[FAIL]"
                failed_cases.append(
                    (i, payload, method_name, expected_status, actual_status)
                )
        except Exception as e:
            status = "[ERROR]"
            failed_cases.append(
                (i, payload, method_name, expected_status, f"ERROR: {e}")
            )
            actual_status = "ERR"

        print(
            f"{status} {i:02d} | {method_name.upper()} | payload={repr(payload):<30} | "
            f"expected={expected_status}, got={actual_status}"
        )
Główna treść programu wykonującego testy penetracyjne została przedstawiona w Listingu 3, gdzie wyliczana dynamicznie jest wyznaczana ilość powtórzeń pętli na podstawie listy przypadków, a w środku niej wykonywane są konkretne przypadki, a błędy przechowywane są w tablicy failed_cases, która w późniejszym etapie pozwoli na wyliczenie niezbędnych metryk.
Listing 4. Formatowanie i wyliczanie statystyk testu w pliku pentest.py. Źródło: opracowanie własne.
    print("\n=== Summary ===")
    print(f"Correct: {correct}/{total}")
    print(f"Accuracy: {correct / total * 100:.2f}%")

    if failed_cases:
        print("\n Failed cases:")
        for i, payload, method, expected, got in failed_cases:
            print(
                f" - Test {i}: {method.upper()} | {repr(payload)} | "
                f"expected={expected}, got={got}"
            )


if __name__ == "__main__":
    run_tests()
Ostatnim etapem pracy nad testami jest przygotowanie ich wizualizacji w celu łatwiejszej prezentacji i szerszego zrozumienia ich rezultatów — na etapie dowodu słuszności koncepcji dobrze sformatowany tekst konsoli jest wystarczający. Kod przygotowujący statystyki został zaprezentowany w Listingu 4.
Został tam również umieszczony warunek sprawdzający, czy wykonywany plik jest plikiem pentest.py; jeżeli tak, to powinna się uruchomić metoda run_tests. Jest to zabezpieczenie przeciwko wykonywaniu kodu w przypadku importu kodu jako biblioteki.[^46]
Rysunek 6. Wynik wykonania skryptu testującego
pentest.py. Źródło: opracowanie własne.
Ostateczny wynik skryptu został zaprezentowany na Rysunku 6, gdzie można ujrzeć sformatowany tekst, mówiący o statusie konkretnych przypadków, a także ogólną skuteczność aplikacji IDPS „AI Web Gateway" — szczegółowa interpretacja tych wyników będzie miała miejsce w rozdziale 4 niniejszej pracy dyplomowej.
3.3.3. Implementacja Wtyczki
Posiadając wiedzę na temat wymagań, architekturę rozwiązania oraz mając przygotowane przypadki testowe, możliwa jest implementacja oprogramowania docelowego. Jako że jest to rozwiązanie bazujące na reverse proxy, uruchamianie go w izolacji nie umożliwia przeprowadzenia rzetelnych testów, więc w pierwszej kolejności trzeba zastanowić się, jak ta aplikacja będzie uruchamiana.
Listing 5. Skrypt o nazwie entrypoint.sh uruchamiający aplikację IDPS. Źródło: opracowanie własne.
#!/bin/bash
TARGET=http://dvwa

echo "[ENTRYPOINT] Startuję IDPS z reverse proxy na $TARGET"

echo "[MITM] Odpalam mitmweb..."
exec mitmweb \
  --mode reverse:$TARGET \
  --listen-port 8080 \
  --web-port 8081 \
  --web-host 0.0.0.0 \
  --listen-host 0.0.0.0 \
  -s /script.py
Skrypt zaprezentowany na Listingu 5 prezentuje formę skryptu uruchamiającego w języku Bash, który odpowiada za wykonanie komendy mitmweb, uruchamiającej interfejs webowy aplikacji na porcie 8081, wraz z zestawieniem tunelu między klientem, który może być dowolny adres wysyłający żądanie na port 8080 zgodnie z przekazanymi argumentami, a także wykorzystany zostanie skrypt Python o nazwie script.py jako nakładka na sniffer mitmproxy.
Listing 6. Import niezbędnych bibliotek script.py. Źródło: opracowanie własne.
import os
import pandas as pd
from mitmproxy import http
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
Pracę nad wtyczką rozpoczęto od importu niezbędnych bibliotek zgodnie z Listingiem 6, takich jak os, umożliwiająca pracę na systemowych ścieżkach plików, biblioteka pandas i moduły sklearn do przetwarzania danych i tworzenia modeli, oraz moduł http z biblioteki mitmproxy do tworzenia wtyczek interpretujących i przetwarzających ruch HTTP i HTTPS.
Listing 7. Konstruktor wtyczki script.py. Źródło: opracowanie własne.
class AIIDS:
    def __init__(self):
        self.vectorizer = TfidfVectorizer(analyzer="char_wb", ngram_range=(3, 5))
        self.model = LogisticRegression()
        self.train()
Klasa AIIDS przedstawiona w Listingu 7 jest głównym elementem programu, który odpowiada za całokształt wtyczki. W jej konstruktorze definiujemy wektoryzator, którego zadaniem jest przekształcenie danych w format bardziej przyjazny dla modelu.
Wektoryzator TF*IDF definiuje wagę danej frazy na podstawie iloczynu czynników TF oraz IDF. Pierwszy z nich to częstotliwość występowania wyrażenia, natomiast drugi to odwrotna częstotliwość. Przekazany parametr char_wb określa sposób tworzenia n-gramu, natomiast krotka ngram_range definiuje rozdzielczość tego n-gramu.[^47]
Poza wektoryzatorem tworzony jest również wstępny, niewytrenowany model regresji logistycznej, który składowany jest jako pole model klasy, a następnie wykonywana jest funkcja treningowa.
Warto zwrócić uwagę, że w komercyjnych środowiskach częstszym rozwiązaniem jest separacja tworzenia i trenowania modelu do osobnych plików, najczęściej wykorzystując specjalne IDE typu Jupyter Notebook, następnie eksportując model do osobnego pliku, a w docelowym rozwiązaniu importuje się gotowy model, w celu redukcji odpowiedzialności, a także usprawnienia czasu tworzenia instancji oprogramowania — jednak na potrzeby niniejszej pracy idea łączenia tych kroków jest wystarczająca do udowodnienia słuszności koncepcji.
Listing 8. Definicja funkcji treningowej modelu script.py. Źródło: opracowanie własne.
def train(self):
    data_path = os.path.join("Data", "Attacks.csv")

    if not os.path.exists(data_path):
        print(f"[AIIDS] Plik treningowy nie znaleziony: {data_path}")
        return

    try:
        df = pd.read_csv(data_path)
        if "Query" not in df.columns or "Label" not in df.columns:
            raise ValueError("CSV musi zawierać kolumny 'Query' i 'Label'")
        queries = df["Query"].astype(str).tolist()
        labels = df["Label"].astype(int).tolist()

        X = self.vectorizer.fit_transform(queries)
        self.model.fit(X, labels)

        print(f"[AIIDS] Model przetrenowany na {len(labels)} próbkach.")
    except Exception as e:
        print(f"[AIIDS] Błąd podczas trenowania: {e}")
Funkcja trenująca model została zaimplementowana zgodnie z Listingiem 8. Zaczytuje dane z pliku CSV, korzystając z funkcji biblioteki pandas — read_csv, która wykonuje w locie konwersję na ramkę danych, czyli specjalny obiekt pandas, umożliwiający przeprowadzanie operacji na wektorach.[^48]
Dalszym etapem jest rozdzielenie danych na wzorce i ich etykiety. Wzorcami w tym przypadku są konkretne fragmenty zapytań HTTP, które następnie są wektoryzowane. Gdy już dane są w formie zwektoryzowanej, należy przystąpić do trenowania modelu, podając do funkcji fit dane oraz etykiety, które posłużą do walidacji wyników treningu i poprawy wag cech przy kolejnych iteracjach uczących.
Listing 9. Funkcja predykcji script.py. Źródło: opracowanie własne.
def predict(self, text):
    try:
        vec = self.vectorizer.transform([text])
        prediction = self.model.predict(vec)[0]
        return prediction == 1
    except Exception as e:
        print(f"[AIIDS] Błąd predykcji: {e}")
        return False
Dobrą praktyką jest zdefiniowanie funkcji pomocniczej predict, tak jak w Listingu 9, która transformuje rzeczywiste zapytania do wspólnej formy z danymi testowymi, co ułatwia zagwarantowanie spójności, jednak nic nie stoi na przeszkodzie, żeby napisać ten sam kod w linii, w której będzie wykorzystywany.
Listing 10. Sniffing ruchu HTTP oraz HTTPS script.py. Źródło: opracowanie własne.
def request(self, flow: http.HTTPFlow):
    params = {}

    # GET params
    for key, value in flow.request.query.items(multi=True):
        params.setdefault(key, []).append(value)

    # POST params (jeśli są)
    if flow.request.method == "POST":
        try:
            for key, value in flow.request.urlencoded_form.items(multi=True):
                params.setdefault(key, []).append(value)
        except Exception:
            pass  # np. brak form-urlencoded

    print(f"[AIIDS] Otrzymano zapytanie: {params}")

    for key, values in params.items():
        for value in values:
            if self.predict(value):
                print(f"[AIIDS] Wykryto SQLi w polu '{key}': {value}")
                flow.response = http.Response.make(
                    403,
                    b"Zablokowane przez AI IDPS: wykryto podejrzane zapytanie SQL",
                    {"Content-Type": "text/plain"},
                )
                return
Listing 10 prezentuje właściwe użycie modelu. Biblioteka mitmproxy wymaga, żeby wtyczka implementowała metodę request, która będzie otrzymywała każde zapytanie przechodzące przez reverse proxy.
Zapytanie następnie jest rozbierane na obiekt zawierający parametry — w przypadku aplikacji „AI Web Gateway" pobierane jest to z zapytań GET i POST, które jako jedyne istnieją w aplikacji DVWA, natomiast implementując kompleksowe rozwiązanie, należy zapewnić obsługę pozostałych metod HTTP analogicznie jak dla metody POST.
Aplikacja następnie iteruje po liście parametrów i normalizuje, a następnie ładuje do predykcji modelu dane, oczekując na wynik pozytywny lub negatywny zapytania. Jeżeli wynik zawartości szkodliwej instrukcji jest pozytywny, następuje blokada zapytania i zwracana jest odpowiedź 403 Forbidden.
Listing 11. Export wtyczki script.py. Źródło: opracowanie własne.
addons = [AIIDS()]Ostatnim krokiem do wykonania jest eksport listy rozszerzeń o nazwie addons, w której znajduje się zaimplementowana wcześniej klasa AIIDS. Ta lista zostanie załadowana do mitmproxy i zostanie wywołany konstruktor trenujący model.[^49]
3.3.4. Konteneryzacja
Posiadając napisaną aplikację, należy przygotować ją do wdrożenia, tworząc paczkę zawierającą prawidłowy obraz aplikacji wraz z zależnościami, a następnie uruchamiając środowisko lokalne zbliżone do produkcyjnego.
Listing 12. Plik Dockerfile konfigurujący obraz aplikacji. Źródło: opracowanie własne.
FROM mitmproxy/mitmproxy:latest

RUN pip install scikit-learn pandas
COPY entrypoint.sh /entrypoint.sh
COPY script.py /script.py
COPY Data /Data

RUN chmod +x /entrypoint.sh
ENTRYPOINT ["/entrypoint.sh"]
Tworząc aplikację, jednym z wymogów nowoczesnej inżynierii oprogramowania jest zapewnienie powtarzalności uruchamiania aplikacji. Prawidłowa sytuacja ma miejsce, gdy aplikacja produkcyjna jest idealną kopią aplikacji na środowisku deweloperskim — powstało wiele sposobów rozwiązania tego problemu, jednym z nich jest Dockerfile.[^50]
Dockerfile to plik konfiguracyjny, uruchamiający aplikacje w dowolnym środowisku zdefiniowanym przez dewelopera, a następnie konfigurujący je do stanu, który aplikacja wymaga do uruchomienia.[^51]
Plik zaprezentowany w Listingu 12 jest właśnie plikiem Dockerfile, który na podstawie obrazu przygotowanego przez mitmproxy instaluje niezbędne zależności, następnie kopiując pliki aplikacji.
Ostatecznie nadaje prawa wykonania przez komendę Linux chmod i ustawia jako punkt wejściowy, czyli polecenie lub skrypt, które zostanie wykonane przez nowopowstały kontener — w tym przypadku jest to omówiony wcześniej skrypt z Listingu 5.
Listing 13. Plik docker-compose.yml tworzący środowisko. Źródło: opracowanie własne.
services:
  dvwa:
    image: vulnerables/web-dvwa
    ports:
      - "8080:80"
    restart: always
    environment:
      - MYSQL_PASSWORD=p@ssw0rd
    depends_on:
      - mysql
    networks:
      - internal

  mysql:
    image: mysql:5.7
    environment:
      MYSQL_ROOT_PASSWORD: p@ssw0rd
      MYSQL_DATABASE: dvwa
    networks:
      - internal

  idps:
    build: ./idps  # katalog z Dockerfile IDPS
    tty: true
    ports:
      - "8081:8081"
    networks:
      - internal

  gateway:
    image: nginx:alpine
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
    ports:
      - "80:80"
    depends_on:
      - idps
    networks:
      - internal

networks:
  internal:
    driver: bridge
Drugą metodą, często stosowaną wspólnie z kontenerami Docker, jest infrastruktura jako kod, w skrócie IaC, która zapewnia deklaratywny sposób tworzenia infrastruktury, która w większości przypadków jest niezmienna. Oczywiście nie nakłada to blokady na administratora systemu, żeby móc zmodyfikować systemy, jednak jest to niezgodne z praktyką i powoduje zwiększenie kosztów poprzez dodanie niepotrzebnych prac utrzymaniowych.[^52]
IaC zakłada, że w momencie potrzeby wykonania zmian w środowisku, zostanie ono postawione od nowa, zachowując jedynie dane poprzez mechanizmy takie jak volume w Dockerze, czy też PVC w Kubernetesie.
Plik docker-compose.yml aplikacji „AI Web Gateway" definiuje serwisy zgodnie z architekturą przestawioną w podpunkcie 3.3.1, oraz bazę danych wymaganą przez aplikację DVWA, poprzez przekazanie prawidłowego obrazu w parametrze image, lub w przypadku Dockerfile — parametru build.
Zdefiniowane zostały również zmienne środowiskowe, które udostępnili autorzy aplikacji, a także sieć wewnętrzna, posiadająca most do sieci hosta, więc aplikacje zostały wystawione poza silnik do konteneryzacji i są dostępne na portach zgodnie z deklaracją ports, gdzie pierwszą wartością jest port dostępny na zewnątrz, natomiast druga wartość po znaku „:" oznacza port wewnętrzny aplikacji zdefiniowany przez autora.
Tak przygotowany plik umożliwia postawienie infrastruktury za pomocą jednej komendy w katalogu z projektem — wystarczy wprowadzić polecenie docker-compose up w systemach Windows lub docker compose up w systemach Linux i MacOS, żeby projekt został uruchomiony. Warto również dodać parametr --build, który buduje ponownie kontenery, jeśli została wykonana zmiana.
Listing 14. Konfiguracja NGINX. Źródło: opracowanie własne.
events {}

http {
    server {
        listen 80;

        location / {
            proxy_pass http://idps:8080;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
        }
    }
}
Poza wyżej wspomnianymi parametrami, zdefiniowany został jeszcze volume dla reverse proxy NGINX, zawierający plik pokazany na Listingu 14, który ma za zadanie przekierowywać ruch do aplikacji IDPS za pomocą parametru proxy_pass, razem z nagłówkami Host i X-Real-IP. Pierwszy z nich pozwala na ustalenie, skąd zostało wywołane zapytanie, natomiast drugi przekazuje do aplikacji, gdzie miało trafić docelowe zapytanie, w celu prawidłowego przekierowania w przypadku, kiedy ruch nie zostanie uznany za szkodliwy.
Jest to popularna konfiguracja NGINX, stosowana często również w przypadku balansowania ruchu sieciowego, budowy API Gateway, a także kiedy NGINX pełni rolę ingress controllera w aplikacjach takich jak Kubernetes.[^53]
Rysunek 7. Wynik wykonania
docker-composedla konfiguracji aplikacji. Źródło: opracowanie własne.
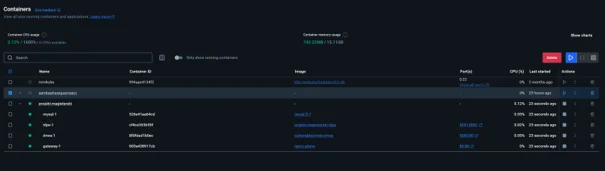
Rysunek 7 prezentuje wynik wykonania pliku docker-compose.yml w programie Docker Desktop[^54] na Windows 11, gdzie można ujrzeć między innymi status kontenerów, ich nazwę, udostępnione porty, a także zasoby przydzielone do kontenerów.
Narzędzie jest wymagane do pracy z kontenerami na systemach Windows, jako że narzędzia do konteneryzacji są dostępne tylko w środowiskach opartych o jądro systemu Linux — wykonuje ono wirtualizację jądra systemu Linux, tworząc lekki podsystem. Alternatywą dla tego rozwiązania jest zastosowanie Windows Subsystem for Linux, które pozwala na instalację pełnoprawnej dystrybucji Linux pod Windowsem.[^55]
Rysunek 8. Wynik wykonania szkodliwego zapytania GET. Źródło: opracowanie własne.
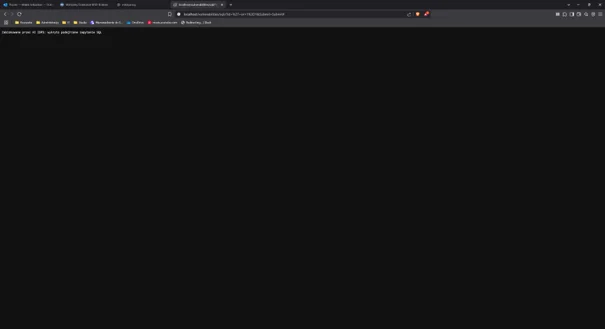
Testowanie aplikacji nie powinno polegać wyłącznie na testach automatycznych, jako że testy automatyczne są pisane przez ludzi — zawsze powinno się przeprowadzić jednostkowe testy manualne w celu weryfikacji, czy w testach automatycznych nie powstał błąd, a przynajmniej podczas ich pierwszego uruchomienia.[^56]
Test manualny pokazany został na Rysunku 8, gdzie do aplikacji zostało przekazane zapytanie GET, na punkt końcowy służący do testowania ataków SQL Injection. Szkodliwy ładunek został zablokowany odpowiedzią 403 Forbidden, zgodnie z założeniami aplikacji.
Aplikacja została zaimplementowana zgodnie z założeniami i jest gotowa do rozstawienia w środowisku produkcyjnym, należy jednak pamiętać o zasadzie braku zaufania do dostawcy oprogramowania i zabezpieczyć aplikację najlepiej dodatkową warstwą ochrony.[^57]
4. Podsumowanie
Posiadając gotowe oprogramowanie w formie „Minimum Viable Product", autor niniejszej pracy naukowej przedstawia wnioski płynące z zaimplementowanego projektu, a także przedstawia zalety zastosowania sztucznej inteligencji w dziedzinie cyberbezpieczeństwa, zwracając uwagę również na zagrożenia wynikające ze zbyt szybkiego rozwoju modeli sztucznej inteligencji.
4.1. Wnioski projektowe
Rozdział poprzedzający udowodnił słuszność koncepcji użycia metodyk sztucznej inteligencji w aplikacjach cyberbezpieczeństwa poprzez implementację aplikacji „AI Web Gateway", która wykorzystuje algorytm regresji logistycznej, wytrenowany na podstawie publicznie dostępnych danych, w celu odparcia ataków na aplikacje internetowe.
Projekt został przygotowany przy użyciu nowoczesnych technologii, które ułatwiły stworzenie imitacji środowiska komercyjnego, w sposób wystarczający do przeprowadzenia rzetelnych testów penetracyjnych.
4.1.1. Stan projektu
Algorytm sztucznej inteligencji, zaprezentowany i omówiony szerzej w rozdziale 3.2 Model, osiągnął skuteczność na poziomie ponad 73%, co jest wynikiem dobrym, biorąc pod uwagę małą próbkę danych.
Najwięcej błędów rozpoznania ma miejsce przy atakach typu Command Injection — jest to atak, który posiadał najmniej liczny zbiór przypadków treningowych, przez co wynik jest zaniżony.[^58]
Ataki SQL Injection i XSS były odpierane prawidłowo przez IDPS, z wyjątkiem pojedynczych przypadków zaprezentowanych w Tabeli 2 — te ataki posiadały najliczniejsze zbiory danych.
Obecny stan modelu pozwala na prowadzenie dalszych prac rozwojowych i implementację kolejnych funkcjonalności wymaganych w środowiskach komercyjnych, jednak należy mieć na uwadze, że nie powinno być to jedyne zabezpieczenie aplikacji — tak jak autor poniższej pracy magisterskiej wspomniał w podrozdziale 2.4 i 2.5, należy stosować kombinacje wielu technologii cyberbezpieczeństwa w celu zapewnienia adekwatnej ochrony dla zasobów organizacji.
4.1.2. Możliwości rozwoju
Istnieje wiele możliwości na rozwinięcie obecnej aplikacji. Najprostszym i najskuteczniejszym jest rozszerzenie zbioru danych o większą liczbę przypadków — przykład różnicy błędów między skutecznością wobec ataków SQL Injection i XSS w porównaniu do Command Injection idealnie obrazuje różnicę, jaką zapewniają jakościowe dane. Zbiór można rozwinąć na wiele sposobów: częstą praktyką jest zakup danych od organizacji, które zajmują się kolekcjonowaniem danych z ataków, albo rozstawienie pułapki, często zwanej honeypot[^59], która symuluje realne maszyny wystawione na publicznie dostępny Internet, pozwalając na zbieranie danych o atakach od aktorów.
Kolejnym punktem rozwoju aplikacji może być zaawansowane logowanie. Mimo iż mitmproxy zapewnia podstawową przeglądarkę logów, integracja z takimi narzędziami jak Grafana czy ELK, a także różnymi narzędziami SIEM, ułatwia pracę nad incydentami jednostką cyberbezpieczeństwa w zakresie raportowania i analizowania incydentów.[^60]
Model można również połączyć z innymi modelami wytrenowanymi do innych typów ataków, rozszerzając perymetr obronny, a także tworząc bardziej kompleksową solucję do obrony aplikacji internetowych, chroniąc je przed przykładowo atakami DDOS, czy też CSRF.
Wspomniana wcześniej separacja trenowania modelu od jego implementacji jest również dobrym pomysłem — w momencie, kiedy do modelu zostałaby dostarczona większa ilość danych, zminimalizowałoby to czas wstawania aplikacji w środowiskach produkcyjnych, gdzie czas niedostępności zazwyczaj jest bardzo kosztowny dla organizacji.
4.2. Wpływ sztucznej inteligencji na obecne zagrożenia w cyberprzestrzeni
Ciągle rozwijane zdolności sztucznej inteligencji i jej rosnące użycie przyczynia się do liczby zagrożeń w cyberbezpieczeństwie — jest to proces analogiczny dla każdej nowej technologii. Za przykład mogą posłużyć komputery kwantowe, które mają możliwości między innymi błyskawicznego łamania haseł w tradycyjnej postaci, dlatego wraz z rozwojem technologii ważna jest jej regulacja i zabezpieczenie.
Same algorytmy uczenia maszynowego mogą posłużyć atakującym do rozwoju narzędzi, takich jak algorytmy deszyfrujące, korzystające z baz haseł do wytrenowania modelu łamiącego hasła techniką brute force, a także generatory tworzenia dynamicznych sygnatur wirusowych, których standardowe antywirusy nie będą w stanie wychwycić.[^61]
Aplikacje zabezpieczające również mogą być celem ataków z wykorzystaniem sztucznej inteligencji, modyfikując zapytania w ataku man-in-the-middle, tak aby blokować ruch, lub utrudniać wykrycie złośliwego kodu.[^62]
Modele procesujące język naturalny, w skrócie NLP, mogą spopularyzować techniki tworzenia ataków, a także same zostać użyte w chociażby phishingu, tworząc fałszywe treści, które są spersonalizowane pod podmiot atakowany, oraz można te modele wykorzystać do OSINT, w celu wyszukania najbardziej wrażliwych informacji.[^63]
Treści propagandowe również mogą być tworzone przez generatywną sztuczną inteligencję, do podszywania się pod sławne osoby, w celach terrorystycznych lub finansowych — już teraz możliwe jest stworzenie głosu czy materiału wideo osoby, które ciężko jest rozróżnić od prawdziwej osoby przez człowieka.
Popularne internetowe chatboty można również wykorzystać do zdobycia danych, na których model był trenowany, lub modyfikować te dane w celu przeprowadzenia oszustwa, przykładowo kierując klientów na podszywające się pod domeny, w celu wyłudzenia kolejnych danych.[^64]
Należy więc wraz z rozwojem tych technologii pracować nad procesami i aplikacjami chroniącymi wrażliwe zasoby przed nowymi zagrożeniami i mieć na uwadze, że każde nowe narzędzie może być słabym punktem w obronie organizacji.[^65]
4.3. Analiza możliwych do zastosowania rozwiązań w cyberbezpieczeństwie z dziedziny sztucznej inteligencji
Rozwój sztucznej inteligencji przynosi nie tylko nowe wektory zagrożeń, ale także umożliwia budowę zaawansowanych mechanizmów obronnych. W literaturze podkreśla się, że rozwiązania oparte na uczeniu maszynowym i głębokim uczeniu pozwalają na analizę wielkich wolumenów danych, adaptacyjne reagowanie na nowe ataki i przewidywanie nieznanych wcześniej wektorów intruzji. Poniżej przedstawiono kluczowe obszary, w których sztuczna inteligencja może znaleźć praktyczne zastosowanie w cyberbezpieczeństwie.
Systemy IDPS tradycyjnie korzystały ze sztywno zdefiniowanych reguł oraz sygnatur, co sprawiło, że ich rozwój i utrzymanie wiązało się z dużymi kosztami implementacji, a także często opóźnieniami w implementacji nowych ataków, często zwanych zero-day. Zastosowanie sztucznej inteligencji w tych systemach zwiększa szansę na wykrycie ataków niepochodzących z wzorców użytych do treningu, a także zmniejsza koszt produkcji i utrzymania poprzez mechanizmy takie jak uczenie ze wzmocnieniem, czy też fine-tuning.[^66]
Modele NLP mogą być również wykorzystywane do analizy forów internetowych, popularnych serwisów społecznościowych, oraz wielu innych źródeł internetowych w ramach wywiadu — stosując techniki takie jak function calling, można z wyprzedzeniem wyszukiwać treści popularnych grup hakerskich odnośnie ich celów ataku i przygotować działania prewencyjne.[^67]
Narzędzia służące do orkiestracji i automatyzacji, w skrócie SOAR, również mogą dużo zyskać poprzez rozszerzenie ich działania nie tylko do wykrywania działań i automatyzacji procesów obsługi incydentów, ale także dając im zdolności do sugerowania bądź podejmowania działań, przykładowo: blokowania zainfekowanych maszyn, korekcji czarnych list, czy też odbierania uprawnień użytkownikom w przypadku infekcji.[^68]
Sieci rekurencyjne i konwolucyjne mogą znaleźć zastosowanie w statycznej analizie kodu źródłowego, detekcji podszywających się stron internetowych oraz maili phishingowych, a także w analizie antywirusowej. W odróżnieniu od klasycznych metod heurystycznych, rozwiązania AI mogą wykrywać nowe, nieznane warianty złośliwego oprogramowania.[^69]
Analiza zachowań użytkowników i dynamiczne zarządzanie uprawnieniami również jest domeną, w której AI jest w stanie rozwinąć obecne aplikacje poprzez dynamiczną detekcję anomalii, takich jak nietypowe logowania czy nagłe wykonywanie masowo trwałych poleceń — takie algorytmy są przydatne w wykrywaniu ataków wewnętrznych, na które do dziś nie ma dobrego sposobu prewencji.[^70]
Analiza literatury i obecnych trendów wskazuje, że sztuczna inteligencja może stanowić kluczowy element przyszłych systemów cyberbezpieczeństwa. Jej największą wartością jest zdolność adaptacji do nowych typów zagrożeń oraz możliwość automatyzacji analizy ogromnych wolumenów danych, które byłyby niemożliwe do przetworzenia przez analityków w czasie rzeczywistym. Z drugiej strony badacze podkreślają konieczność dalszego rozwoju metod odpornych na ataki adwersarialne oraz dbania o wysoką jakość danych treningowych. Każde rozwiązanie AI, podobnie jak każde nowe narzędzie w infrastrukturze IT, może stać się potencjalnym wektorem ataku i wymaga odpowiedniego audytu bezpieczeństwa.[^71]
4.4. Podsumowanie pracy
W pracy magisterskiej przedstawiono projekt i implementację systemu Intrusion Detection and Prevention System warstwy aplikacyjnej, działającego jako proxy HTTP/HTTPS. System ten wykorzystuje mitmproxy do przechwytywania ruchu, a następnie analizuje go z użyciem modelu uczenia maszynowego, ze szczególnym uwzględnieniem regresji logistycznej jako wybranej metody bazowej. Rozwiązanie zostało skonteneryzowane i przygotowane do wdrożenia w chmurze Microsoft Azure, Google Cloud Platform, oraz Amazon AWS, co umożliwia jego łatwe uruchamianie i skalowanie.
Analiza literatury oraz badania eksperymentalne wykazały, że modele AI są skuteczne w detekcji ataków typu SQL Injection, XSS czy Command Injection, choć ich efektywność zależy w dużym stopniu od jakości i zrównoważenia danych treningowych. Największe trudności zaobserwowano przy atakach Command Injection, które były słabo reprezentowane w zbiorach danych, co skutkowało zwiększoną liczbą błędów klasyfikacji. Zjawisko to potwierdza tezy literatury o problemie class imbalance w systemach bezpieczeństwa opartych na ML.
W pracy wskazano także na możliwe kierunki dalszego rozwoju, w tym integrację systemu z narzędziami SIEM, wykorzystanie technik uczenia głębokiego, a także implementację automatycznych mechanizmów reakcji na incydenty. Podkreślono jednocześnie, że choć sztuczna inteligencja znacząco podnosi skuteczność detekcji zagrożeń, sama również może stać się celem ataków, przykładowo: data poisoning, adversarial examples, co wymaga budowania odpornych modeli i uwzględniania ryzyka na etapie projektowania.
Podsumowując, zaprezentowane rozwiązanie stanowi dowód, że integracja proxy, sztucznej inteligencji i nowoczesnych technologii wdrożeniowych, takich jak kontenery czy chmura, może być skuteczną metodą wzmocnienia ochrony aplikacji webowych. Praca ukazuje praktyczny potencjał AI w cyberbezpieczeństwie, a jednocześnie wskazuje na ograniczenia i wyzwania, które powinny być przedmiotem dalszych badań.
5. Bibliografia
5.1. Spis literatury
- Thomas D., Hunt A., „Pragmatyczny programista. Od czeladnika do mistrza. Wydanie II", Helion, 2021
- Cooper A., „The Inmates Are Running the Asylum", Pearson Education, 2000
- Revella A., „Buyer Persona. Poznaj i zrozum decyzje zakupowe swoich klientów", MT Biznes, 2021
- Mitnick K., Wozniak S., Simon W.L., „Duch w sieci", Helion, 2019
- Vajjala S., Majumder B., Gupta A., Surana H., „Przetwarzanie języka naturalnego w praktyce. Przewodnik po budowie rzeczywistych systemów NLP", Helion, 2023
- Chelladhurai J.S., Singh V., Raj P., „Docker dla praktyków. Wydanie II", Helion, 2018
- Woolley S., „Manufacturing Consensus: Understanding Propaganda in the Era of Automation and Anonymity", Yale University Press, 2023
- Sikos F. L., „AI in Cybersecurity", Springer, 2019
5.2. Artykuły naukowe
- Ulah A.M., Jamal A.A., Tuhin R.A., Akhter S., „Detecting distributed denial of service attacks using logistic regression and SVM methods", źródło: arxiv.org/pdf/2411.14512 [27.07.2025]
- Disha A.R., Waheed S., „Performance analysis of machine learning models for intrusion detection system using Gini Impurity-based Weighted Random Forest (GIWRF) feature selection technique", źródło: cybersecurity.springeropen.com [27.07.2025]
- Chalichalamala S., Govidan N., Kasarapu R., „Logistic Regression Ensemble Classifier for Intrusion Detection System in Internet of Things", źródło: mdpi.com [27.07.2025]
- Schroer S. L., Pajola L., Castagnaro A., Apruzzese G., „Exploiting AI for Attacks: On the Interplay between Adversarial AI and Offensive AI", źródło: arxiv.org/html/2506.12519v1 [20.08.2025]
- Kolosnjaji B., Demontis A., Biggio B., Maiorca D., Giacinto G., Eckert C., Roli F., „Adversarial Malware Binaries: Evading Deep Learning for Malware Detection in Executables", źródło: arxiv.org/abs/1803.04173 [20.08.2025]
- Zhao C., Si S., Tu T., Shi Y., Qin S., „Deep-Learning Based Injection Attacks Detection Method for HTTP", źródło: mdpi.com [21.08.2025]
- Buczak A. L., Guven E., „A Survey of Data Mining and Machine Learning Methods for Cyber Security Intrusion Detection", źródło: ieeexplore.ieee.org [22.08.2025]
- Sommer R., Paxson V., „Outside the Closed World: On Using Machine Learning for Network Intrusion Detection", źródło: researchgate.net [22.08.2025]
- Hyrum S. A., „Evading Machine Learning Malware Detection", źródło: semanticscholar.org [22.08.2025]
- Iqbal H. S., Kayes A. S. M., Badsha S., Alqahtani H., Watters P., Ng A., „Cybersecurity data science: an overview from machine learning perspective", źródło: journalofbigdata.springeropen.com [22.08.2025]
- Mohiuddin A., Abdun M., Jiankun H., „A Survey of Network Anomaly Detection Techniques", źródło: researchgate.net [22.08.2025]
5.3. Źródła internetowe
- Scarfone K., Mell P., „Guide to Intrusion Detection and Prevention Systems (IDPS)", źródło: nvlpubs.nist.gov [16.05.2025]
- Red Hat, „What is an intrusion detection and prevention system (IDPS)?", źródło: redhat.com [16.05.2025]
- OWASP Foundation, „OWASP Top Ten", źródło: owasp.org [16.05.2025]
- Cisco Secure Docs, „Snort 3 Adoption", źródło: secure.cisco.com [16.05.2025]
- Combs R., „Snort 3.0 with ElasticSearch, LogStash, and Kibana (ELK)", źródło: blog.snort.org [16.05.2025]
- Salmon M., „Suricata and OSSEC IDPS Systems Review", źródło: researchgate.net [16.05.2025]
- Persona Institut, „Persona knowledge: the history of buyer personas", źródło: persona-institut.de [09.06.2025]
- Agile Alliance, agilemanifesto.org [09.06.2025]
- Gartner, „Cybersecurity Leadership", gartner.com [09.06.2025]
- Bloomer T., „Do IT Managers Fit in an SMB?", cortavo.com [10.06.2025]
- Swimlane, „Roles & Responsibilities of a DevSecOps Engineer", swimlane.com [09.06.2025]
- Ramirez A., „Digital transformation driven by community: Kubernetes as example", źródło: cncf.io [20.05.2025]
- Strona główna „Wojsk Obrony Cyberprzestrzeni", źródło: cyber.mil.pl [27.07.2025]
- Rapid7, lista grup APT, źródło: docs.rapid7.com [27.07.2025]
- Hakon Software, „Triada CIA w cyberbezpieczeństwie: Klucz do bezpieczeństwa IT", źródło: hakon.pl [27.07.2025]
- Fortinet, „What Is Defense In Depth?", źródło: fortinet.com [27.07.2025]
- Fortinet, „What Is Cybersecurity Mesh?", źródło: fortinet.com [27.07.2025]
- Resilia, „Co to jest norma ISO 27001 i dlaczego jest tak ważna dla organizacji?", źródło: resilia.pl [30.07.2025]
- Medium, „Persistence || Backdoor Techniques (Beginner to Advanced) in Linux", źródło: infosecwriteups.com [27.07.2025]
- Mitre Corporation, „ATT&CK", źródło: attack.mitre.org [27.07.2025]
- OWASP Foundation, „A03:2021 – Injection", źródło: owasp.org [27.07.2025]
- Mitre Corporation, „Phishing", źródło: attack.mitre.org [27.07.2025]
- Mitre Corporation, „Replication Through Removable Media", źródło: attack.mitre.org [27.07.2025]
- FlowHunt, „Model Chaining", źródło: flowhunt.io [27.07.2025]
- Mitmproxy, biblioteka do monitorowania ruchu HTTP/HTTPS, źródło: mitmproxy.org [21.05.2025]
- SciKit-Learn, biblioteka zawierająca popularne implementacje algorytmów z dziedziny uczenia maszynowego, źródło: scikit-learn.org [22.07.2025]
- Serwer aplikacji NGINX, źródło: nginx.org [22.07.2025]
- Aplikacja DVWA, źródło: github.com/digininja/DVWA [22.07.2025]
- Technologia konteneryzacji Docker, źródło: docker.com [22.07.2025]
- Kajdanowicz T., Tagowski K., Rajda K., Sawczyn A., Bielak P., „Zaawansowane przetwarzanie tekstów", źródło: pwr-ai.github.io [27.07.2025]
- Broniewski P., „Reverse proxy. Co to jest i jak działa reverse proxy?", źródło: webporadnik.pl [21.05.2025]
- Sandeep D., „Kubernetes best practices: How and why to build small container images", źródło: cloud.google.com [21.05.2025]
- BrowserStack, „How to write Test Cases in Software Testing?", źródło: browserstack.com [27.07.2025]
- Biblioteka do wykonywania zapytań w języku Python, źródło: pypi.org/project/requests [23.07.2025]
- Myrianthous G., „What Does "If
__name__== '__main__'" Do in Python?", źródło: builtin.com [23.07.2025] - Oficjalna dokumentacja biblioteki Pandas, „DataFrame", źródło: pandas.pydata.org [27.07.2025]
- Oficjalna dokumentacja biblioteki MITMProxy, „Addons", źródło: docs.mitmproxy.org [27.07.2025]
- Dokumentacja Docker, „Dockerfile reference", źródło: docs.docker.com [27.07.2025]
- Buchanan I., „Infrastruktura jako kod", źródło: atlassian.com [27.07.2025]
- Oficjalna dokumentacja NGINX, „NGINX Reverse Proxy", źródło: docs.nginx.com [30.07.2025]
- Narzędzie do zarządzania kontenerami Docker Desktop, źródło: docker.com/products/docker-desktop [27.05.2025]
- Microsoft, „How to install Linux on Windows with WSL", źródło: learn.microsoft.com [30.07.2025]
- Buła A., „Do you really need a manual tester and why the answer is "yes"?", źródło: rst.software [27.07.2025]
- Crowdstrike, „Data Poisoning: The Exploitation of Generative AI", źródło: crowdstrike.com [20.08.2025]
- nFlo, „Co to jest Honeypot?", źródło: nflo.pl [19.08.2025]
- Prakash A., „Real-Time Continuous Monitoring with a SIEM Using the ELK Stack", źródło: arunprakashpj.medium.com [21.08.2025]
- Cloudflare, „What is a supply chain attack?", źródło: cloudflare.com [21.08.2025]
- Legaspi C., „The Collaboration Paradox: When Security Tools Become Your Biggest Vulnerability", źródło: avepoint.com [21.08.2025]
6. Spis tabel
- Tabela 1: Fragment danych treningowych modelu
- Tabela 2: Przypadki testowe do testów penetracyjnych
7. Spis ilustracji
- Rysunek 1: GUI aplikacji Snort, Źródło: blog.snort.org [21.05.2025]
- Rysunek 2: GUI aplikacji Suricata, Źródło: suricata.io/features [21.05.2025]
- Rysunek 3: Przeglądarka logów biblioteki MITMProxy, źródło: opracowanie własne
- Rysunek 4: Interfejs aplikacji DVWA, źródło: opracowanie własne
- Rysunek 5: Schemat architektury sieciowej aplikacji, źródło: opracowanie własne
- Rysunek 6: Wynik wykonania skryptu testującego pentest.py, źródło: opracowanie własne
- Rysunek 7: Wynik wykonania docker-compose dla konfiguracji aplikacji, źródło: opracowanie własne
- Rysunek 8: Wynik wykonania szkodliwego zapytania GET, źródło: opracowanie własne
8. Spis fragmentów kodu
- Listing 1: Konfiguracja testów penetracyjnych pliku pentest.py, źródło: opracowanie własne
- Listing 2: Zdefiniowanie metod testowych w pliku pentest.py, źródło: opracowanie własne
- Listing 3: Implementacja test runnera w pliku pentest.py, źródło: opracowanie własne
- Listing 4: Formatowanie i wyliczanie statystyk testu w pliku pentest.py, źródło: opracowanie własne
- Listing 5: Skrypt o nazwie entrypoint.sh uruchamiający aplikację IDPS, źródło: opracowanie własne
- Listing 6: Import niezbędnych bibliotek script.py, źródło: opracowanie własne
- Listing 7: Konstruktor wtyczki script.py, źródło: opracowanie własne
- Listing 8: Definicja funkcji treningowej modelu script.py, źródło: opracowanie własne
- Listing 9: Funkcja predykcji script.py, źródło: opracowanie własne
- Listing 10: Sniffing ruchu HTTP oraz HTTPS script.py, źródło: opracowanie własne
- Listing 11: Export wtyczki script.py, źródło: opracowanie własne
- Listing 12: Plik Dockerfile konfigurujący obraz aplikacji, źródło: opracowanie własne
- Listing 13: Plik docker-compose.yml tworzący środowisko, źródło: opracowanie własne
- Listing 14: Konfiguracja NGINX, źródło: opracowanie własne
Przypisy
[^1]: Scarfone K., Mell P., „Guide to Intrusion Detection and Prevention Systems (IDPS)", źródło: https://nvlpubs.nist.gov/nistpubs/legacy/sp/nistspecialpublication800-94.pdf [16.05.2025] [^2]: Red Hat, „What is an intrusion detection and prevention system (IDPS)?", źródło: https://www.redhat.com/en/topics/security/what-is-an-IDPS [16.05.2025] [^3]: OWASP Foundation, „OWASP Top Ten", źródło: https://owasp.org/www-project-top-ten/ [16.05.2025] [^4]: Cisco Secure Docs, „Snort 3 Adoption", źródło: https://secure.cisco.com/secure-firewall/docs/snort-3-adoption [16.05.2025] [^5]: Combs R., „Snort 3.0 with ElasticSearch, LogStash, and Kibana (ELK)", źródło: https://blog.snort.org/2017/11/snort-30-with-elasticsearch-logstash.html [16.05.2025] [^6]: Salmon M., „Suricata and OSSEC IDPS Systems Review", źródło: https://www.researchgate.net/publication/361825906_Suricata_and_OSSEC_IDPS_Systems_Review_April_2022 [16.05.2025] [^7]: Persona Institut, „Persona knowledge: the history of buyer personas", źródło: https://www.persona-institut.de/en/die-geschichte-der-buyer-personas/ [09.06.2025] [^8]: Cooper A., „The Inmates Are Running the Asylum", Pearson Education, 2000 [^9]: Agile Alliance, https://agilemanifesto.org/iso/pl/manifesto.html [09.06.2025] [^10]: Revella A., „Buyer Persona. Poznaj i zrozum decyzje zakupowe swoich klientów", MT Biznes, 2021 [^11]: Gartner, „Cybersecurity Leadership", https://www.gartner.com/en/cybersecurity/role/chief-information-security-officer [09.06.2025] [^12]: Bloomer T., „Do IT Managers Fit in an SMB?", https://cortavo.com/cortavo-blogs/what-role-should-your-it-manager-play-in-your-smb [10.06.2025] [^13]: Swimlane, „Roles & Responsibilities of a DevSecOps Engineer", https://swimlane.com/blog/devsecops-roles-responsibilites/ [09.06.2025] [^14]: Ramirez A., „Digital transformation driven by community: Kubernetes as example", źródło: https://www.cncf.io/blog/2025/01/30/digital-transformation-driven-by-community-kubernetes-as-example/ [20.05.2025] [^15]: Thomas D., Hunt A., „Pragmatyczny programista. Od czeladnika do mistrza. Wydanie II", Helion, 2021 [^16]: Mitnick K., Wozniak S., Simon W.L., „Duch w sieci", Helion, 2019 [^17]: Strona główna „Wojsk Obrony Cyberprzestrzeni", źródło: https://www.cyber.mil.pl/ncbc-dkwoc/ [27.07.2025] [^18]: Rapid7, lista grup APT, źródło: https://docs.rapid7.com/insightidr/apt-groups/ [27.07.2025] [^19]: Hakon Software, „Triada CIA w cyberbezpieczeństwie: Klucz do bezpieczeństwa IT", źródło: https://hakon.pl/triada-cia-w-cyberbezpieczenstwie-klucz-do-bezpieczenstwa-it/ [27.07.2025] [^20]: Fortinet, „What Is Defense In Depth?", źródło: https://www.fortinet.com/resources/cyberglossary/defense-in-depth [27.07.2025] [^21]: Fortinet, „What Is Cybersecurity Mesh?", źródło: https://www.fortinet.com/resources/cyberglossary/what-is-cybersecurity-mesh [27.07.2025] [^22]: Resilia, „Co to jest norma ISO 27001 i dlaczego jest tak ważna dla organizacji?", źródło: https://resilia.pl/blog/iso-27001-czym-jest-jakie-daje-korzysci/ [30.07.2025] [^23]: Lindemulder G., „What is open source intelligence (OSINT)?", źródło: https://www.ibm.com/think/topics/osint [27.07.2025] [^24]: Buckman B., „What is Weaponization in Cybersecurity? A Guide for IT Professionals", źródło: https://www.huntress.com/cybersecurity-education/cybersecurity-101/topic/what-is-weaponization-in-cybersecurity [27.07.2025] [^25]: Koken N., „Breaking down the cyberattack lifecycle: Delivery", źródło: https://www.todyl.com/blog/cyberattack-lifecycle-delivery [27.07.2025] [^26]: Medium, „Persistence || Backdoor Techniques (Beginner to Advanced) in Linux", źródło: https://infosecwriteups.com/persistence-backdoor-techniques-beginner-to-advanced-in-linux-dd7e109ceeb9 [27.07.2025] [^27]: OWASP Foundation, „OWASP Top Ten", źródło: https://owasp.org/www-project-top-ten/ [27.07.2025] [^28]: Mitre Corporation, „ATT&CK", źródło: https://attack.mitre.org/# [27.07.2025] [^29]: OWASP Foundation, „A03:2021 – Injection", źródło: https://owasp.org/Top10/A03_2021-Injection/ [27.07.2025] [^30]: Mitre Corporation, „Phishing", źródło: https://attack.mitre.org/techniques/T1566/ [27.07.2025] [^31]: Mitre Corporation, „Replication Through Removable Media", źródło: https://attack.mitre.org/techniques/T1091/ [27.07.2025] [^32]: FlowHunt, „Model Chaining", źródło: https://www.flowhunt.io/glossary/model-chaining/ [27.07.2025] [^33]: Mitmproxy, biblioteka do monitorowania ruchu HTTP/HTTPS, źródło: https://mitmproxy.org/ [21.05.2025] [^34]: SciKit-Learn, biblioteka zawierająca popularne implementacje algorytmów z dziedziny uczenia maszynowego, źródło: https://scikit-learn.org/stable/index.html [22.07.2025] [^35]: Serwer aplikacji NGINX, źródło: https://nginx.org/en/ [22.07.2025] [^36]: Aplikacja DVWA, źródło: https://github.com/digininja/DVWA?tab=readme-ov-file [22.07.2025] [^37]: Technologia konteneryzacji Docker, źródło: https://www.docker.com/ [22.07.2025] [^38]: Kajdanowicz T., Tagowski K., Rajda K., Sawczyn A., Bielak P., „Zaawansowane przetwarzanie tekstów", źródło: https://pwr-ai.github.io/przetwarzanie-danych-i-odkrywanie-wiedzy/laboratoria/lab6-uczenie-maszynowe-2.html [27.07.2025] [^39]: Ulah A.M., Jamal A.A., Tuhin R.A., Akhter S., „Detecting distributed denial of service attacks using logistic regression and SVM methods", źródło: https://arxiv.org/pdf/2411.14512 [27.07.2025] [^40]: Disha A.R., Waheed S., „Performance analysis of machine learning models for intrusion detection system using Gini Impurity-based Weighted Random Forest (GIWRF) feature selection technique", źródło: https://cybersecurity.springeropen.com/articles/10.1186/s42400-021-00103-8 [27.07.2025] [^41]: Chalichalamala S., Govidan N., Kasarapu R., „Logistic Regression Ensemble Classifier for Intrusion Detection System in Internet of Things", źródło: https://www.mdpi.com/1424-8220/23/23/9583 [27.07.2025] [^42]: Broniewski P., „Reverse proxy. Co to jest i jak działa reverse proxy?", źródło: https://webporadnik.pl/reverse-proxy-co-to-jest-i-jak-dziala-reverse-proxy [21.05.2025] [^43]: Sandeep D., „Kubernetes best practices: How and why to build small container images", źródło: https://cloud.google.com/blog/products/containers-kubernetes/kubernetes-best-practices-how-and-why-to-build-small-container-images [21.05.2025] [^44]: BrowserStack, „How to write Test Cases in Software Testing?", źródło: https://www.browserstack.com/guide/how-to-write-test-cases [27.07.2025] [^45]: Biblioteka do wykonywania zapytań w języku Python, źródło: https://pypi.org/project/requests/ [23.07.2025] [^46]: Myrianthous G., „What Does "If __name__ == '__main__'" Do in Python?", źródło: https://builtin.com/articles/name-python [23.07.2025] [^47]: Vajjala S., Majumder B., Gupta A., Surana H., „Przetwarzanie języka naturalnego w praktyce. Przewodnik po budowie rzeczywistych systemów NLP", Helion, 2023 [^48]: Oficjalna dokumentacja biblioteki Pandas, „DataFrame", źródło: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.html [27.07.2025] [^49]: Oficjalna dokumentacja biblioteki MITMProxy, „Addons", źródło: https://docs.mitmproxy.org/stable/addons/overview/ [27.07.2025] [^50]: Chelladhurai J.S., Singh V., Raj P., „Docker dla praktyków. Wydanie II", Helion, 2018 [^51]: Dokumentacja Docker, „Dockerfile reference", https://docs.docker.com/reference/dockerfile/ [27.07.2025] [^52]: Buchanan I., „Infrastruktura jako kod", źródło: https://www.atlassian.com/pl/microservices/cloud-computing/infrastructure-as-code [27.07.2025] [^53]: Oficjalna dokumentacja NGINX, „NGINX Reverse Proxy", źródło: https://docs.nginx.com/nginx/admin-guide/web-server/reverse-proxy/ [30.07.2025] [^54]: Narzędzie do zarządzania kontenerami Docker Desktop, źródło: https://www.docker.com/products/docker-desktop/ [27.05.2025] [^55]: Microsoft, „How to install Linux on Windows with WSL", źródło: https://learn.microsoft.com/en-us/windows/wsl/install [30.07.2025] [^56]: Buła A., „Do you really need a manual tester and why the answer is "yes"?", źródło: https://www.rst.software/blog/do-you-really-need-a-manual-tester-and-why-the-answer-is-yes [27.07.2025] [^57]: Cloudflare, „What is a supply chain attack?", źródło: https://www.cloudflare.com/pl-pl/learning/security/what-is-a-supply-chain-attack/ [21.08.2025] [^58]: Zhao C., Si S., Tu T., Shi Y., Qin S., „Deep-Learning Based Injection Attacks Detection Method for HTTP", źródło: https://www.mdpi.com/2227-7390/10/16/2914 [21.08.2025] [^59]: nFlo, „Co to jest Honeypot?", źródło: https://nflo.pl/slownik/honeypot/ [19.08.2025] [^60]: Prakash A., „Real-Time Continuous Monitoring with a SIEM Using the ELK Stack", źródło: https://arunprakashpj.medium.com/real-time-continuous-monitoring-with-a-siem-using-the-elk-stack-a536df7e77c0 [21.08.2025] [^61]: Schroer S. L., Pajola L., Castagnaro A., Apruzzese G., „Exploiting AI for Attacks: On the Interplay between Adversarial AI and Offensive AI", źródło: https://arxiv.org/html/2506.12519v1 [20.08.2025] [^62]: Kolosnjaji B., Demontis A., Biggio B., Maiorca D., Giacinto G., Eckert C., Roli F., „Adversarial Malware Binaries: Evading Deep Learning for Malware Detection in Executables", źródło: https://arxiv.org/abs/1803.04173 [20.08.2025] [^63]: Woolley S., „Manufacturing Consensus: Understanding Propaganda in the Era of Automation and Anonymity", Yale University Press, 2023 [^64]: Crowdstrike, „Data Poisoning: The Exploitation of Generative AI", https://www.crowdstrike.com/en-us/cybersecurity-101/cyberattacks/data-poisoning [20.08.2025] [^65]: Legaspi C., „The Collaboration Paradox: When Security Tools Become Your Biggest Vulnerability", źródło: https://www.avepoint.com/shifthappens/blog/the-collaboration-paradox-when-security-tools-become-your-biggest-vulnerability [21.08.2025] [^66]: Buczak A. L., Guven E., „A Survey of Data Mining and Machine Learning Methods for Cyber Security Intrusion Detection", źródło: https://ieeexplore.ieee.org/document/7307098 [22.08.2025] [^67]: Sommer R., Paxson V., „Outside the Closed World: On Using Machine Learning for Network Intrusion Detection", źródło: https://www.researchgate.net/publication/220713766_Outside_the_Closed_World_On_Using_Machine_Learning_for_Network_Intrusion_Detection [22.08.2025] [^68]: Hyrum S. A., „Evading Machine Learning Malware Detection", źródło: https://www.semanticscholar.org/paper/Evading-Machine-Learning-Malware-Detection-Anderson/1b570ed4b58908444465823880cb88fbb812b4fc [22.08.2025] [^69]: Iqbal H. S., Kayes A. S. M., Badsha S., Alqahtani H., Watters P., Ng A., „Cybersecurity data science: an overview from machine learning perspective", źródło: https://journalofbigdata.springeropen.com/articles/10.1186/s40537-020-00318-5 [22.08.2025] [^70]: Mohiuddin A., Abdun M., Jiankun H., „A Survey of Network Anomaly Detection Techniques", źródło: https://www.researchgate.net/publication/286848340_A_Survey_of_Network_Anomaly_Detection_Techniques [22.08.2025] [^71]: Sikos F. L., „AI in Cybersecurity", Springer, 2019